혼자 도는 발행
사람이 자리에 없어도 매일 결과물이 나가고, 죽으면 스스로 살아나고, 잰 값이 다음 규격을 바꾸는 파이프라인. 만드는 순서 그대로.
코드를 못 읽어도 됩니다. 연두색 상자를 복사해 AI에게 붙여넣으면 만들어집니다. 도구 고르는 법과 비용, 돈이 나오는 자리를 고르는 전략부터 시작합니다.
목차
아무것도 모르는 상태에서 첫 30분
터미널을 한 번도 안 열어본 분을 기준으로 씁니다. 이 장을 끝내면 나머지 장의 명령을 실행할 수 있습니다.
STEP 0
터미널 열기
이 책에는 검은 상자에 든 명령이 나옵니다. 그걸 어디에 입력하는지부터 말씀드립니다.
윈도우
- 키보드에서 윈도우 키를 누릅니다
- powershell 이라고 칩니다
- 목록에 나온 Windows PowerShell 을 엽니다
파란 창이 열리고 PS C:\Users\이름> 같은 글자가 보이면 성공입니다.
맥
- command + 스페이스 를 누릅니다
- 터미널 이라고 칩니다
- 엔터를 누릅니다
흰 창이 열리고 이름@맥이름 ~ % 같은 글자가 보이면 성공입니다.
여기에 글자를 치고 엔터를 누르면 컴퓨터가 그 일을 합니다. 마우스로 누르는 것과 같은 일인데, 글자로 시키는 것뿐입니다. 명령을 잘못 쳐도 대부분 "그런 명령 없음"이라고만 하고 아무 일도 안 일어납니다. 겁내지 마세요.
알아둘 명령 다섯 개
이 다섯 개면 이 책 전체를 따라올 수 있습니다.
pwd
ls          (맥)
dir         (윈도우)
mkdir auto
cd auto
cd ..
터미널에서는 마우스 오른쪽 클릭이 붙여넣기인 경우가 많습니다. 윈도우 PowerShell은 오른쪽 클릭 한 번으로 붙습니다. 맥은 command+V 가 됩니다.
STEP 0
파이썬 설치
이 책이 만드는 것은 파이썬으로 돌아갑니다. 먼저 이것부터 깔아야 합니다. 무료입니다.
윈도우
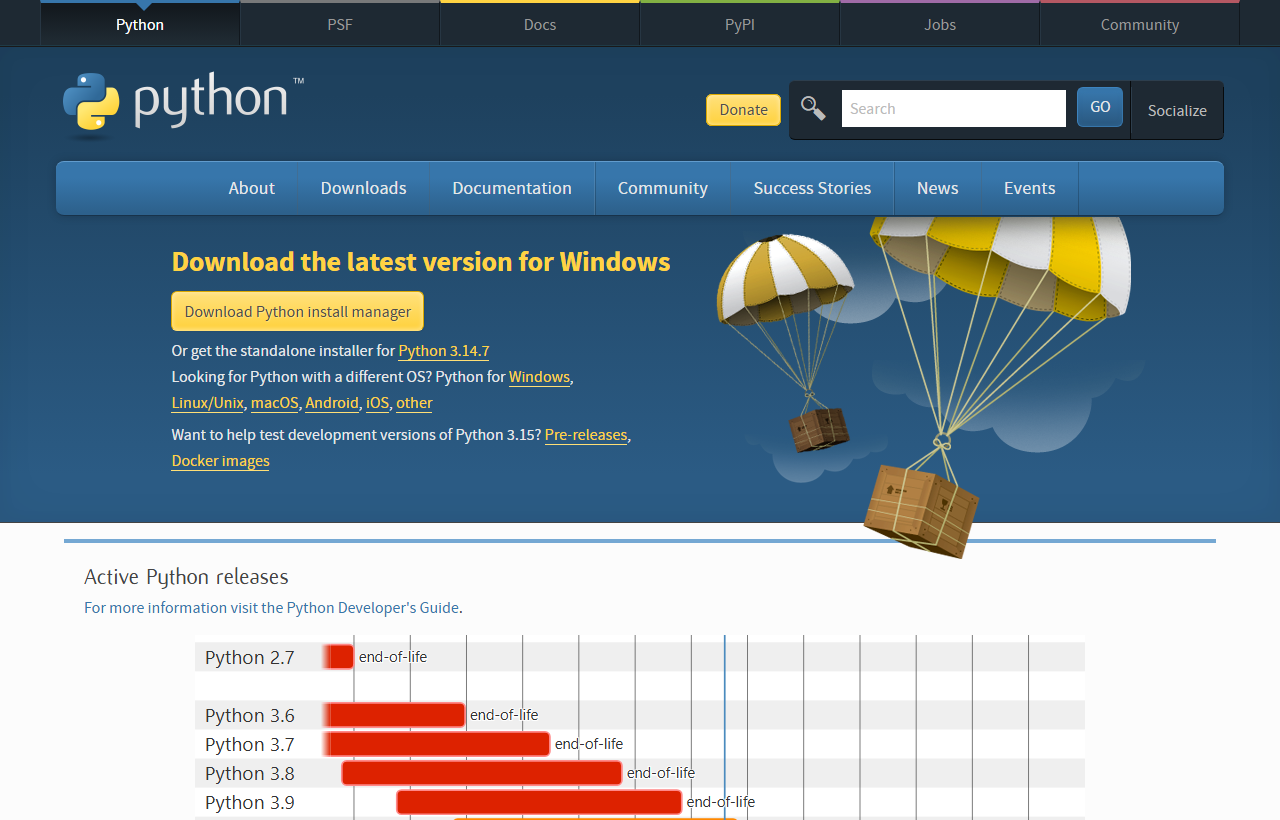
python.org/downloads로 들어갑니다- 큰 노란 버튼(설치 관리자)이나, 그 아래 standalone installer 링크 중 아무거나 받습니다
- 설치 창이 뜨면 맨 아래 체크박스를 반드시 켭니다 — Add python.exe to PATH
- Install Now 를 누릅니다
- 터미널을 완전히 닫았다가 다시 엽니다
맥
- 대부분 이미 깔려 있습니다. 먼저 확인부터 하세요
- 없다고 나오면
python.org에서 받아 설치합니다 - 설치 후 터미널을 닫았다 다시 엽니다
윈도우에서 Add python.exe to PATH 를 안 켜면 설치는 됐는데 터미널이 파이썬을 못 찾습니다. 초보가 제일 많이 막히는 자리이고, 나중에 고치기도 번거롭습니다. 이미 설치했는데 안 되면 삭제하고 이 체크박스를 켜서 다시 설치하는 게 제일 빠릅니다.
python --version
윈도우에서 위 명령이 안 되면 py --version 을 해보세요. 둘 중 하나는 됩니다. 되는 쪽을 기억해 두시고, 이 책의 python 을 그걸로 바꿔 읽으면 됩니다.
pip --version
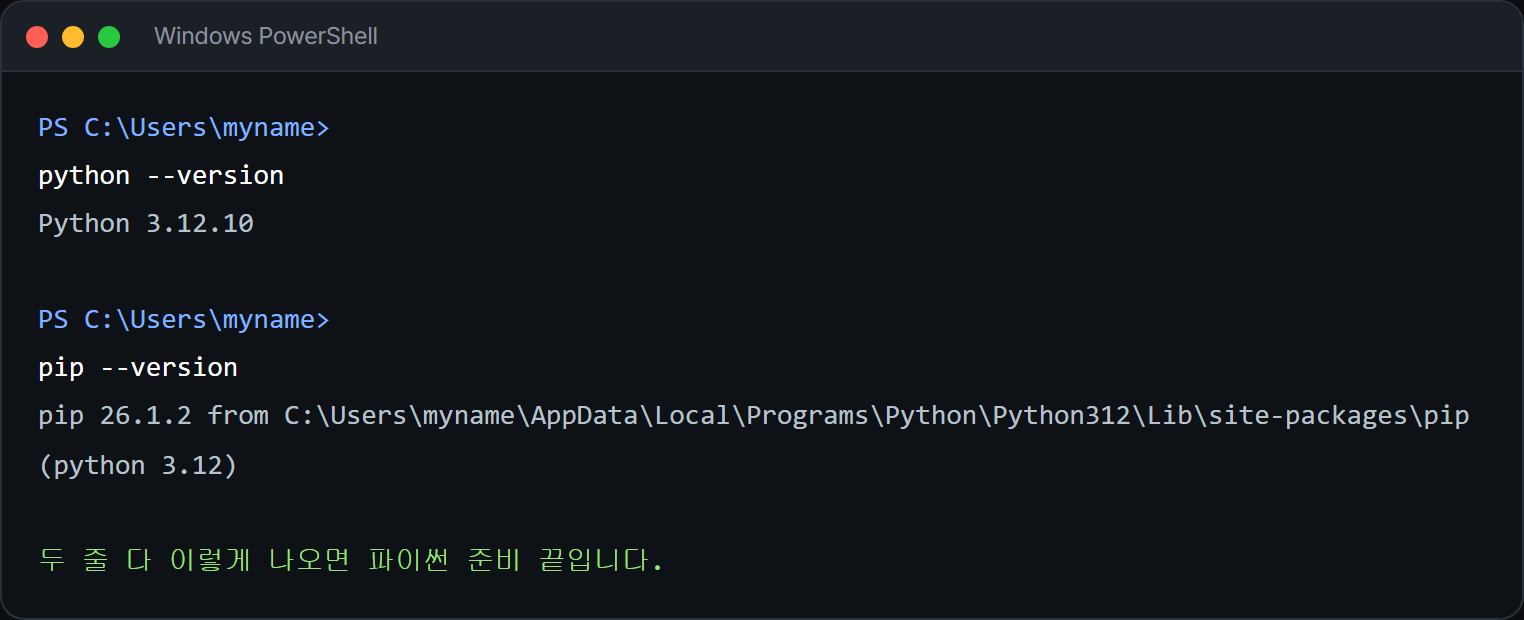
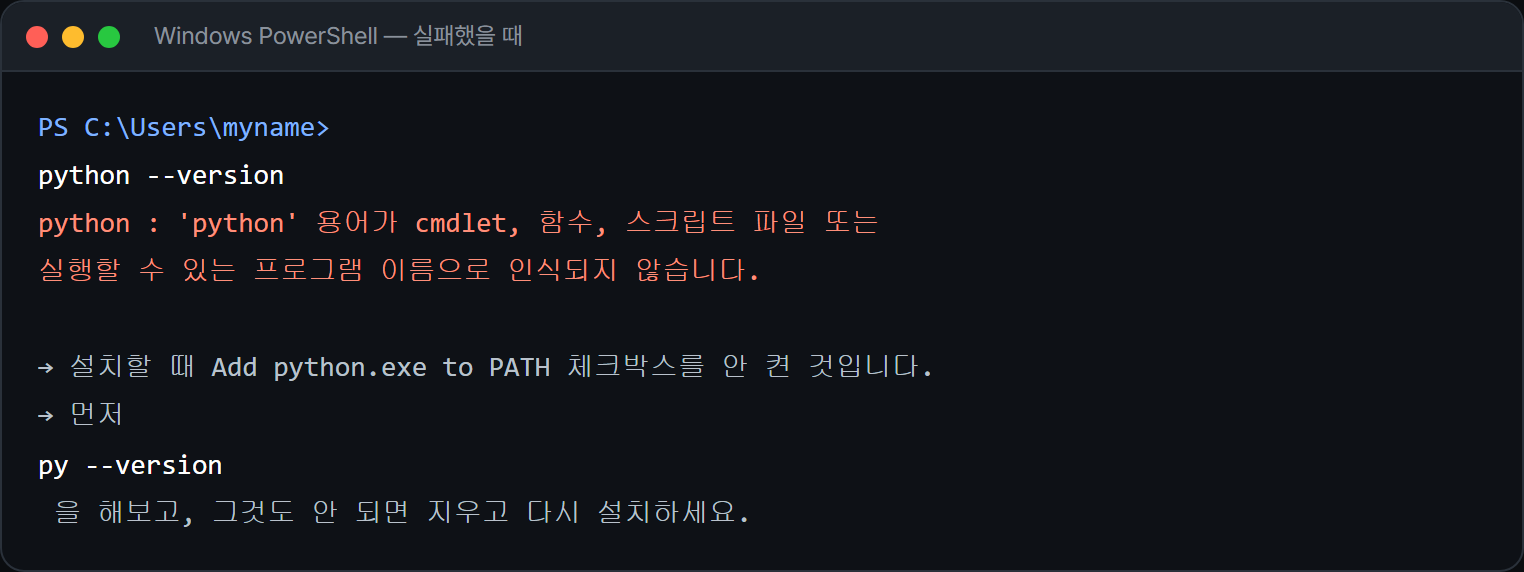
이것도 버전이 찍혀야 합니다. 16.5장에서 브라우저 도구를 깔 때 씁니다. 안 되면 python -m pip --version 을 해보세요.
STEP 0
작업 폴더 만들기
앞으로 만들 파일이 전부 여기 들어갑니다. 한 번 정하면 안 바꾸는 게 좋습니다.
cd ~
mkdir auto
cd auto
pwd
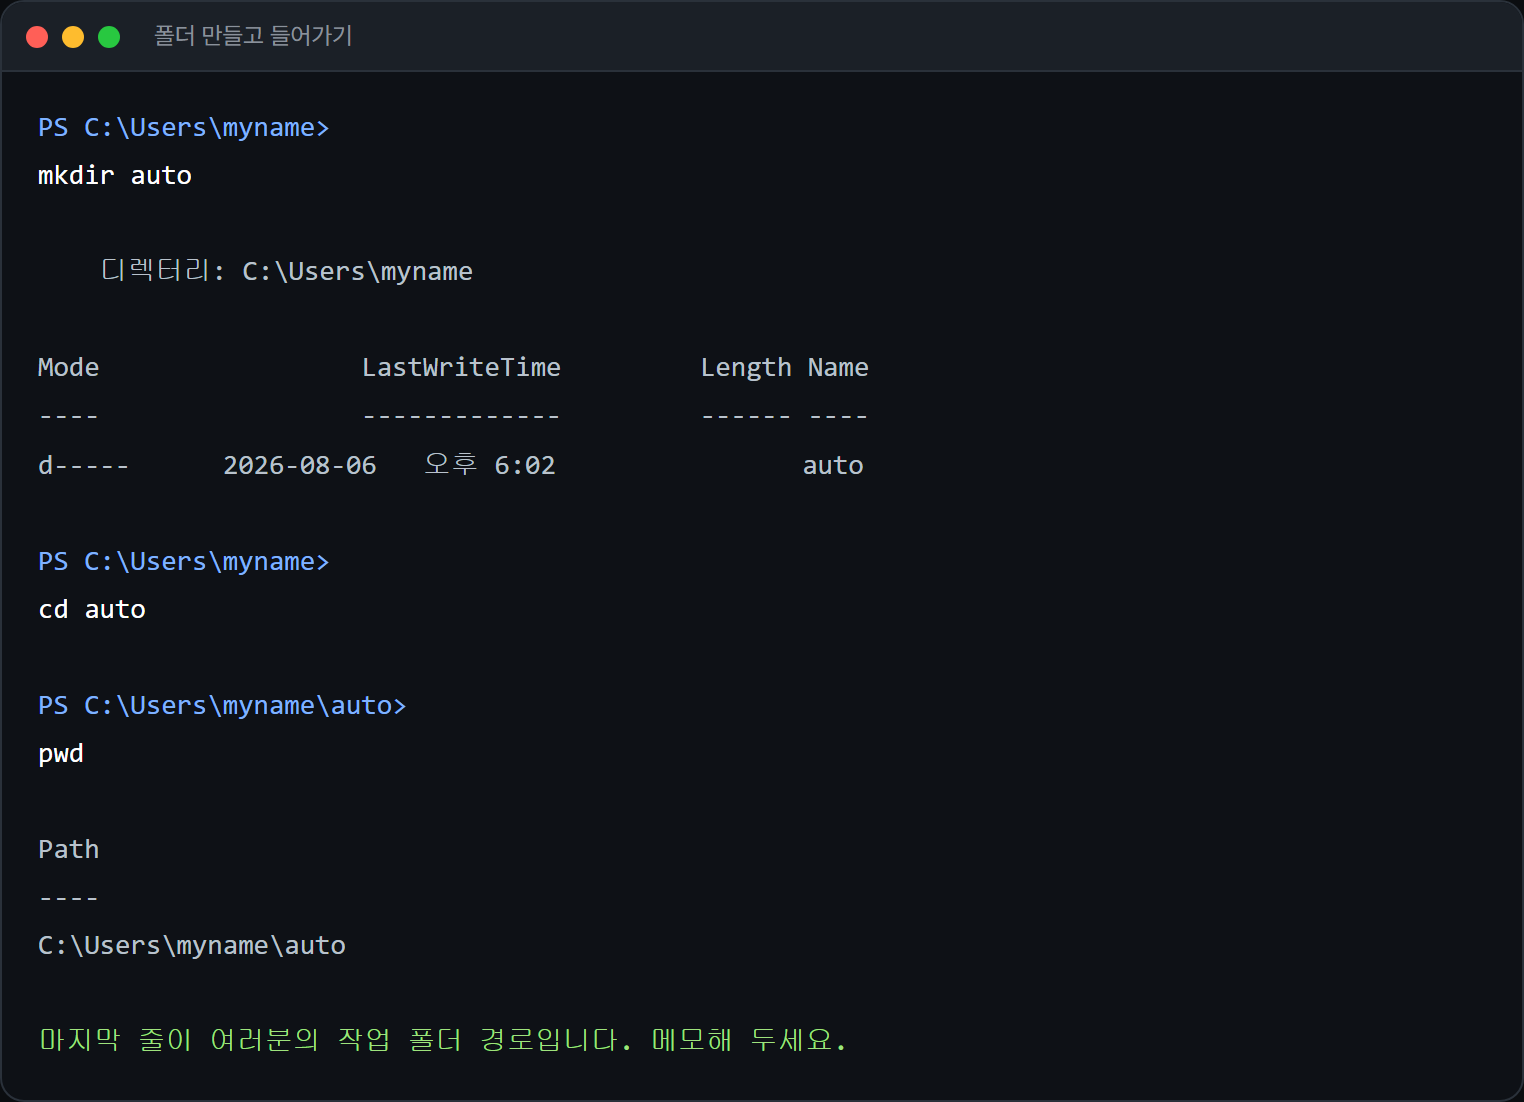
마지막 pwd 가 찍어주는 것이 여러분의 작업 폴더 경로입니다. 메모해 두세요. 나중에 스케줄러에 등록할 때 이 경로가 필요합니다.
터미널을 닫았다 열면 홈 폴더에서 시작합니다. 작업할 때마다 cd auto 로 들어가야 합니다. 코딩 에이전트도 이 폴더 안에서 실행해야 그 폴더의 파일을 봅니다.
확장자 없는 파일 만들기
.env 라는 파일을 만들어야 하는데, 메모장으로 저장하면 .env.txt 가 됩니다. 그러면 프로그램이 못 찾습니다.
echo. > .env          (윈도우)
touch .env            (맥)
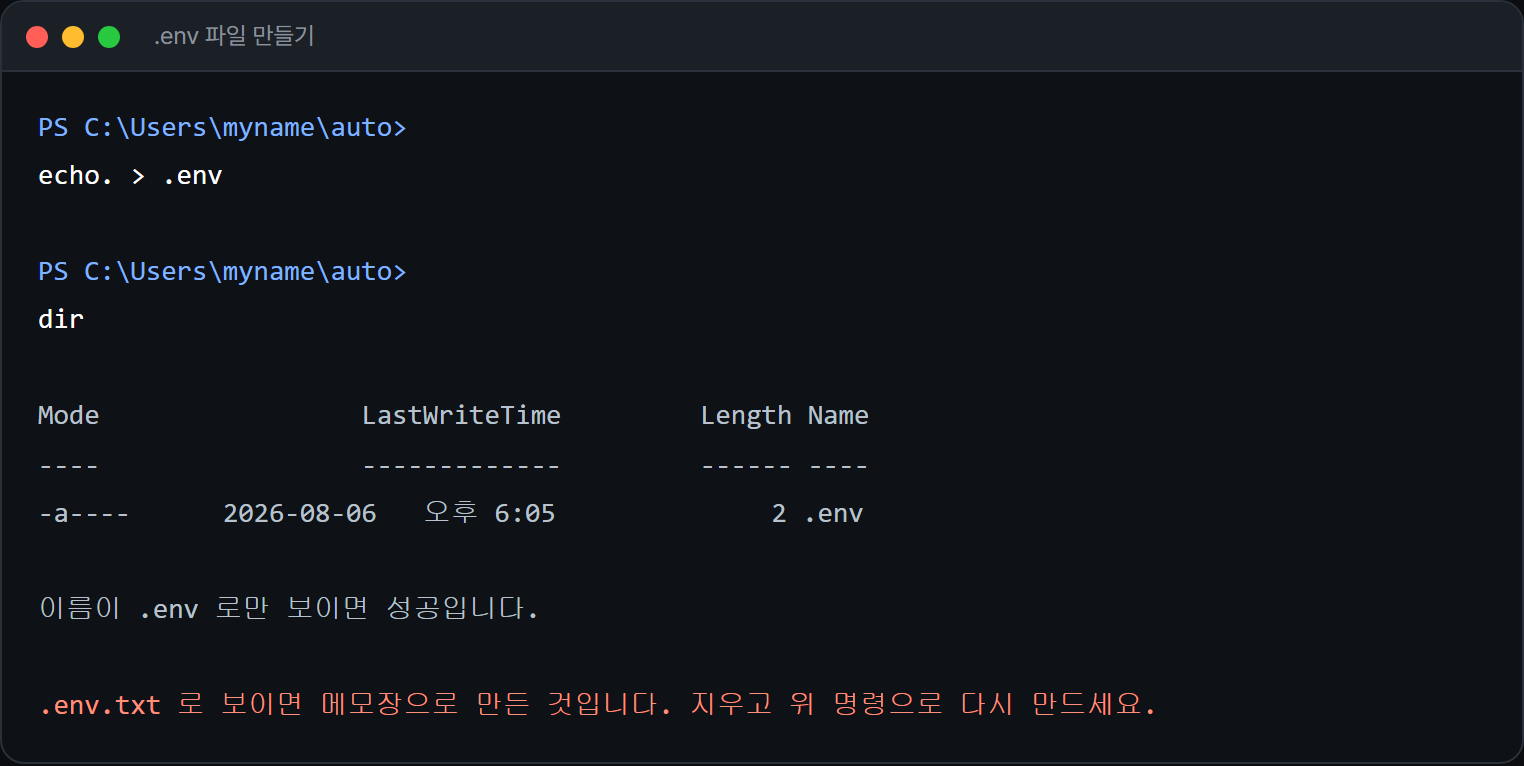
만든 뒤에는 메모장이나 텍스트 편집기로 열어서 내용을 채우면 됩니다. 코딩 에이전트를 쓰신다면 "이 폴더에 .env 파일을 만들어 줘"라고 하면 알아서 만들어 줍니다.
STEP 0
용어 스무 개
이 책에 나오는 말 중 설명 없이 쓰는 것들입니다. 몰라도 따라올 수 있지만, 알면 훨씬 편합니다.
- 터미널
- 글자로 컴퓨터에 명령을 시키는 창. 윈도우는 PowerShell, 맥은 터미널.
- 명령
- 터미널에 치는 한 줄. 엔터를 눌러야 실행됩니다.
- 경로
- 파일이나 폴더가 있는 위치.
C:\Users\이름\auto같은 것. - 확장자
- 파일 이름 끝의
.py.json같은 부분. 무슨 종류인지 알려줍니다. - 패키지 · 라이브러리
- 남이 만들어 둔 기능 묶음.
pip install로 받습니다. - 스크립트
- 명령을 여러 줄 모아둔 파일. 실행하면 위에서부터 차례로 돕니다.
- 실행
- 그 파일을 돌리는 것.
python 파일이름.py - 표준 출력
- 프로그램이 화면에 찍는 정상 결과.
- 오류 출력
- 프로그램이 화면에 찍는 오류 메시지. 정상 결과와 따로 관리합니다.
- 종료코드
- 프로그램이 끝날 때 남기는 숫자. 0이면 성공, 나머지는 각각 다른 실패나 상태를 뜻합니다.
- 파이프
- 앞 명령의 결과를 뒤 명령에 넘기는 것.
|기호를 씁니다. - API
- 다른 서비스에 프로그램으로 물어보는 창구.
- 키
- 그 창구를 쓸 자격증. 남에게 보여주면 안 됩니다.
- 배치
- 정해진 순서대로 한 번 쭉 도는 것. 이 책에서는 하루 한 바퀴.
- 스케줄러
- 정해진 시각에 프로그램을 대신 실행해 주는 기능. 윈도우는 작업 스케줄러.
- 로그
- 무슨 일이 있었는지 적어두는 기록 파일.
- 잠금
- 같은 프로그램이 두 번 동시에 돌지 않게 막는 장치.
- 캐시
- 한 번 받아온 것을 저장해 두고 다시 안 묻는 것.
- 규격
- 결과물의 모양을 숫자로 정해둔 것. 줄 길이, 이미지 수 같은 것.
- 축
- 판정 기준이 같은 소재 묶음. 이슈 축, 상품 축처럼.
터미널을 열 수 있고, 폴더를 만들고 들어갈 수 있고, 파이썬이 깔려 있습니다. 이제 다음 장에서 코딩 에이전트를 설치합니다. 여기서 막히면 그 상태를 그대로 말하면 됩니다 — "PowerShell 을 열었는데 python --version 을 치니 이렇게 나와요" 처럼요.
준비 — 무엇으로, 얼마에
코드를 못 읽어도 됩니다. 다만 도구는 골라야 하고, 그 도구에는 돈과 한계가 있습니다. 그것부터 정확히 적습니다.
준비 1
이 책을 쓰는 법
이 책에는 코드가 나옵니다. 그걸 보고 덮으실까 봐 이 장을 맨 앞에 뒀습니다. 코드는 여러분이 쓰는 게 아닙니다.
여러분이 할 일은 세 가지뿐입니다
하나. 연두색 상자를 복사합니다.
둘. AI에게 붙여넣고 엔터를 누릅니다.
셋. AI가 만들어 주는 파일을 저장하고, 알려주는 명령을 그대로 실행합니다.
코드를 읽을 필요도, 고칠 필요도 없습니다. 어디가 잘못되면 그 에러 메시지를 그대로 다시 붙여넣으시면 됩니다. 그게 이 책이 상정한 사용법입니다.
| 상자 | 무엇인가 | 여러분이 하는 일 |
|---|---|---|
| 연두색 | AI에게 주는 지시문 | 복사 → 붙여넣기 → 엔터 |
| 검은색 | AI가 만들 결과물의 예시 | 읽지 않아도 됩니다. 대조용입니다 |
| 점선 | 바로 위 지시문으로 만들어질 파일 | 아무것도 안 하셔도 됩니다 |
터미널을 한 번도 안 열어봤다면: 바로 앞의 STEP 0 를 먼저 하세요. 파이썬 설치와 폴더 만들기까지 30분입니다. 그게 안 돼 있으면 이 장부터는 못 따라옵니다.
초보이고 빨리 시작하고 싶다면: 준비부(3장)와 전략부(3장)를 읽고, 그 다음부터는 각 장의 연두색 상자만 순서대로 복사하세요. 지시문은 전부 본문 안에 있습니다. 부록 F는 그것만 한자리에 모아둔 것이라 나중에 다시 쓸 때 편합니다.
왜 그렇게 만드는지 알고 싶다면: 1부부터 순서대로 읽으세요. 나중에 뭔가 안 될 때 고칠 수 있는 건 그 이유를 아는 사람뿐입니다.
준비 2
도구와 비용 — 무엇을 얼마에 쓰나
코드를 대신 써 줄 도구가 필요합니다. 대화창에 물어보는 것과, 내 컴퓨터의 파일을 직접 만들어 주는 것은 다릅니다.
두 가지 방식
| 방식 | 무엇인가 | 이 책에 맞나 |
|---|---|---|
| 대화창 | 웹이나 앱에서 물어보고, 답을 복사해 내가 파일로 저장 | 가능합니다. 파일이 스무 개라 손이 많이 갑니다 |
| 코딩 에이전트 | 터미널에서 돌면서 파일을 직접 만들고 고치고 실행까지 | 권합니다. 저장·실행을 대신 해줍니다 |
대화창만으로도 이 책은 끝까지 갑니다. 다만 파일 스무 개를 손으로 저장하다 3장에서 지치기 쉽습니다. 코딩 에이전트를 쓰면 "만들어 줘"라고 하면 파일이 실제로 생깁니다.
고를 수 있는 것들
| 도구 | 설치 | 비용 | 특징 |
|---|---|---|---|
| 클로드 코드 | 터미널 명령 한 줄 | 구독 $20~ | 파일 조작·실행에 강함. 긴 작업을 끝까지 끌고 감 |
| 코덱스 CLI | npm install -g @openai/codex | 구독 $20~ | 무료 구간에서도 제한적으로 씀. 챗GPT 계정 연결 |
| 대화창 (웹) | 없음 | 무료~$20 | 파일은 내가 저장. 시작 비용이 0 |
구독은 대체로 월 20달러 구간에서 시작하고, 사용량이 많으면 100~200달러 구간으로 올라갑니다. 요금제와 한도는 수시로 바뀝니다. 이 책에 적힌 금액을 그대로 믿지 마시고, 시작하는 날 공식 요금 페이지를 한 번 여세요.
중요한 건 금액이 아니라 과금 방식입니다. 구독은 정해진 시간 창(보통 5시간) 안에서 쓸 수 있는 양이 정해져 있고, 넘으면 기다려야 합니다. API 키로 쓰면 창 제한 없이 쓴 만큼 내는데, 이쪽은 무심코 큰 작업을 시키면 금액이 빨리 올라갑니다.
파이프라인을 처음부터 끝까지 만드는 데 드는 작업량은 구독 한 달치 안입니다. 대화가 길어져 한도에 걸리면 몇 시간 기다렸다 이어가면 되고, 그게 싫으면 그 달만 상위 구간을 쓰고 내리면 됩니다.
파이프라인이 돌기 시작한 뒤 매달 나가는 돈은 0원입니다. 이 책의 판정·측정·학습은 전부 무료 API와 표준 라이브러리로 돌아갑니다. 글을 AI로 쓰신다면 그 몫만 듭니다.
설치 — 명령 한 줄
AI에게 물어보라고 하면 옛 정보로 답하는 일이 잦습니다. 그래서 실제 명령을 그대로 적습니다. 확인은 공식 문서에서 한 번 더 하세요.
클로드 코드
Pro·Max 이상 구독이 필요합니다. 무료 플랜으로는 안 됩니다. 사양은 맥 13 이상, 윈도우 10(1809) 이상, 램 4GB 이상입니다.
curl -fsSL https://claude.ai/install.sh | bash
irm https://claude.ai/install.ps1 | iex
winget install Anthropic.ClaudeCode
프롬프트에 PS C:\ 가 보이면 PowerShell, C:\ 만 보이면 CMD입니다. 위 명령은 셸이 다르면 오류가 납니다.
그리고 윈도우에서는 Git for Windows를 같이 설치하는 걸 권합니다. 없어도 돌지만, 있으면 도구가 훨씬 자연스럽게 동작합니다.
설치 확인과 로그인
claude --version
claude doctor
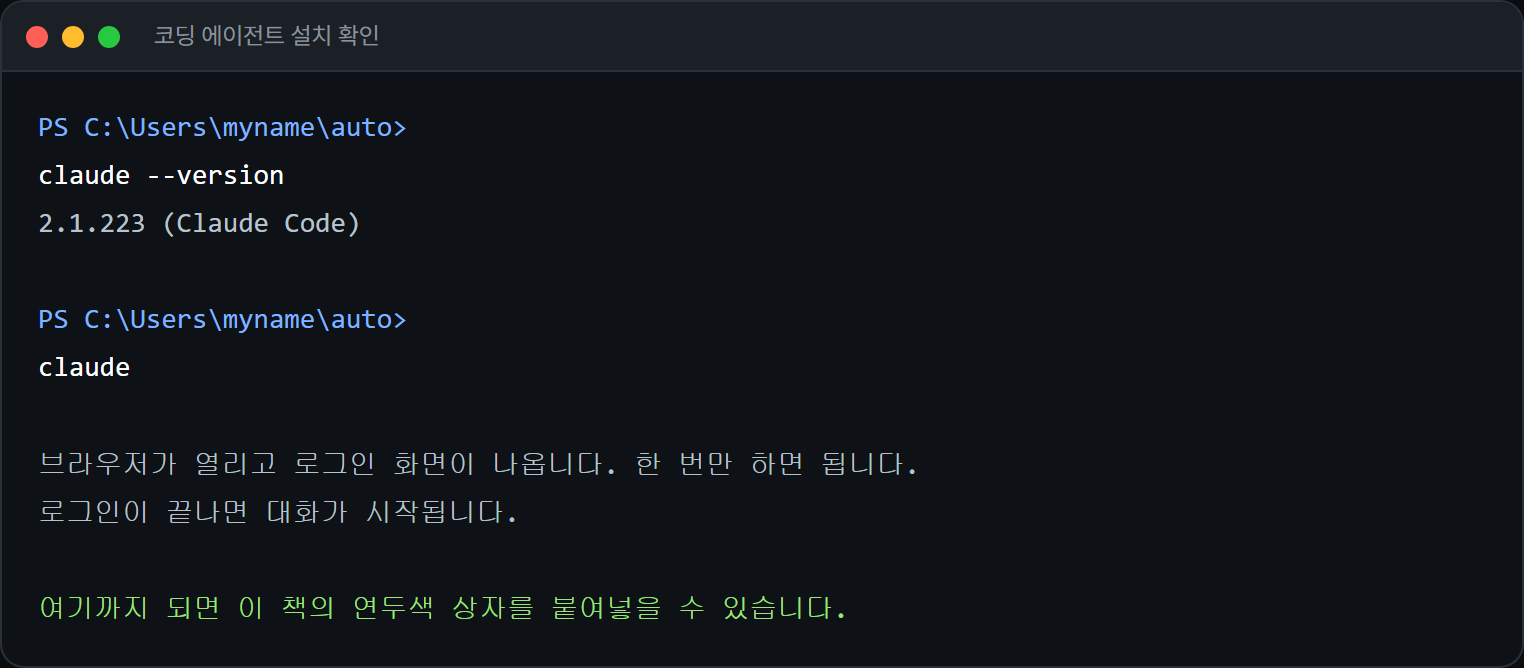
작업할 폴더를 하나 만들고 그 안에서 claude 를 실행하면 대화가 시작됩니다. 처음이면 브라우저가 열리고 로그인 절차가 나옵니다. 한 번만 하면 됩니다.
코덱스 CLI
챗GPT 구독을 쓰신다면 이쪽입니다. Node 가 먼저 필요합니다.
npm install -g @openai/codex
설치 후 실행하면 챗GPT 계정 연결을 물어봅니다. 연결하면 구독 한도 안에서 씁니다.
command not found 가 나오면 터미널을 완전히 닫았다 다시 여세요. 설치가 경로에 반영되려면 새 창이 필요합니다. 그래도 안 되면 아래를 복사해 대화창에 붙여넣으세요.
코딩 에이전트를 설치하려는데 막혔어. 나는 터미널이 처음이야.

내 운영체제는 (윈도우 / 맥) 이고, 이 명령을 실행했어.
(실행한 명령 붙여넣기)

이런 결과가 나왔어.
(화면에 나온 것을 처음부터 끝까지 붙여넣기)

다음을 알려줘.
1) 지금 내가 쓰고 있는 게 PowerShell 인지 CMD 인지 확인하는 법
2) 이 오류의 원인
3) 다음에 실행할 명령 하나만. 여러 개 주지 말고 하나씩
4) 성공하면 화면에 무엇이 나오는지
키 두 개 받기 — 15분
4~8장의 판정이 이 두 개로 돌아갑니다. 둘 다 무료이고 사업자 등록도 필요 없습니다. 화면 구성은 바뀔 수 있으니 메뉴 이름이 다르면 비슷한 것을 찾으세요.
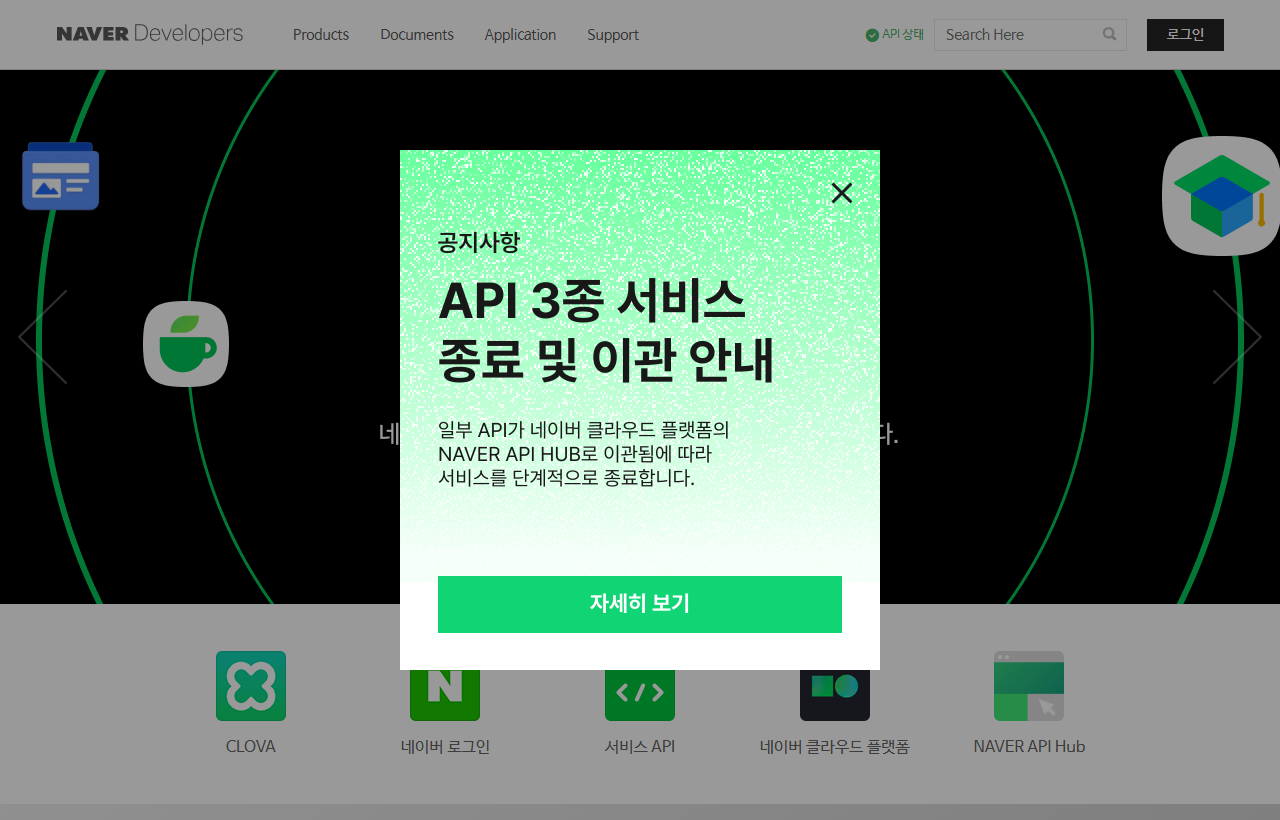
① 문서 수를 세는 키 — 오픈 API
developers.naver.com에 접속해 네이버 아이디로 로그인합니다.- 애플리케이션 등록(또는 오픈 API 이용 신청) 메뉴로 들어갑니다.
- 애플리케이션 이름은 아무거나 적습니다. 사용 API에서 검색을 고릅니다.
- 환경은 웹 서비스 URL을 요구할 수 있습니다. 없으면
http://localhost를 넣으세요. - 등록하면 Client ID 와 Client Secret 이 나옵니다. 이 둘을
.env에 넣습니다.
② 검색량을 보는 키 — 검색광고 API
searchad.naver.com에 접속해 가입합니다. 광고를 집행하지 않아도 계정은 만들 수 있습니다.- 로그인 후 도구 메뉴에서 API 사용 관리를 찾습니다.
- 액세스 라이선스를 발급하면 액세스 라이선스 와 비밀키 가 나옵니다.
- 고객 ID 도 필요합니다. 계정 정보나 화면 상단에서 확인할 수 있습니다. 숫자입니다.
- 이 세 개를
.env에 넣습니다.
NAVER_CLIENT_ID=
NAVER_CLIENT_SECRET=
NAVER_AD_API_KEY=
NAVER_AD_SECRET=
NAVER_AD_CUSTOMER=
AI에게는 "여기에 키를 넣을 자리를 만들어 줘"까지만 시키고, 값은 여러분이 직접 파일에 적어 넣습니다. 그리고 이 파일은 어디에도 올리지 마세요.
API 키를 발급받으려는데 화면이 안내와 달라. 나는 비개발자야.

지금 (developers.naver.com / searchad.naver.com) 에 들어와 있고,
화면에는 이런 메뉴들이 보여.
(보이는 메뉴 이름들을 그대로 적어주세요)

내가 받아야 하는 건
- 블로그 문서 개수를 세는 검색 API 의 클라이언트 아이디와 시크릿
- 키워드 월간 검색량을 보는 검색광고 API 의 액세스 라이선스, 비밀키, 고객 아이디

어느 메뉴를 순서대로 눌러야 하는지 한 단계씩 알려줘.
입력하라는 항목이 나오면 뭘 적어야 하는지도 알려줘.
사업자 정보를 요구하면 개인도 되는지 알려줘.
알아둘 한계
- 사용량 한도. 구독에는 시간 창당 한도가 있습니다. 긴 작업을 몰아서 시키면 중간에 막힙니다. 이 책은 장 단위로 끊어 시키게 설계돼 있어 한도에 덜 걸립니다.
- 대화가 길어지면 느려지고 잊습니다. 앞에서 만든 파일을 기억 못 하기 시작하면, "지금까지 만든 파일 목록과 역할을 정리해 줘"라고 한 뒤 그 정리를 새 대화 맨 앞에 붙이고 이어가세요.
- AI는 자신 있게 틀립니다. 특히 외부 서비스의 요금·정책·화면 구성은 옛 정보로 답하는 일이 잦습니다. 돈이 걸린 항목은 반드시 공식 페이지를 직접 확인하세요.
- 키를 대화창에 붙여넣지 마세요. AI에게는 "여기에 키를 넣을 자리를 만들어 줘"까지만 시키고, 값은 여러분이 직접 파일에 넣습니다.
준비 3
시키는 법 — 골모드
같은 도구를 써도 결과가 크게 갈립니다. 지시하는 방식 때문입니다.
골모드란
중간에 되묻지 말고 끝까지 알아서 완성하라고 미리 못 박는 방식입니다. 이렇게 하지 않으면 AI가 단계마다 "이렇게 할까요?"를 물어서, 결국 여러분이 판단을 다 해야 합니다. 코드를 모르는 사람에게 그건 최악의 상황입니다.
앞으로 이 대화에서는 이렇게 해줘.

[역할]
나는 프로그래밍을 모른다. 코드를 읽지도 고치지도 못한다.
너가 판단하고 너가 만든다. 나는 복사해서 저장하고 실행만 한다.

[진행 방식]
- 중간에 "이렇게 할까요?" 라고 묻지 말고, 네가 판단해서 끝까지 완성해라.
  선택지가 있으면 하나를 고르고 왜 골랐는지 한 줄로만 알려줘.
- 파일을 줄 때는 항상 "파일 이름"과 "전체 내용"을 통째로 줘라.
  일부만 고친 조각은 주지 마라. 나는 어디를 바꿔야 하는지 모른다.
- 명령을 알려줄 때는 어디에 입력하는지, 성공하면 화면에 무엇이 나오는지
  같이 알려줘라.
- 전문 용어를 쓰면 바로 옆에 한 줄로 풀어 써라.

[품질 기준]
- 설치가 필요한 외부 라이브러리는 쓰지 마라. 표준 기능만 써라.
  (예외: 발행 층에서만 브라우저 자동화 라이브러리를 쓴다. 그때 내가 말해줄게)
- 파일 이름을 파이썬 표준 라이브러리와 겹치게 짓지 마라.
- 실패했을 때 조용히 넘어가지 말고 무엇이 왜 실패했는지 남겨라.
- 내가 에러를 붙여넣으면, 원인을 설명하고 고친 파일 전체를 다시 줘라.

[끝났을 때]
- 무엇을 만들었는지, 다음에 무엇을 하면 되는지 세 줄로 정리해라.

이해했으면 "알겠다" 한 마디만 하고 기다려. 다음 지시를 줄게.
막혔을 때 쓰는 말 네 가지
| 상황 | 그대로 쓰시면 되는 말 |
|---|---|
| 에러가 났다 | "이 에러가 났어. (붙여넣기) 원인을 설명하고, 고친 파일 전체를 다시 줘. 나는 코드를 못 읽어." |
| 무슨 말인지 모르겠다 | "방금 설명을 프로그래밍 모르는 사람 기준으로 다시 해줘. 비유를 써도 좋아." |
| 어디에 넣는지 모르겠다 | "그 파일을 어느 폴더에 어떤 이름으로 저장하는지, 폴더 만드는 법부터 알려줘." |
| AI가 딴 얘기를 한다 | "지금까지 만든 파일 목록과 각 역할을 정리해 줘." → 그 정리를 새 대화 맨 앞에 붙이고 다시 시작 |
에러가 나는 건 실패가 아니라 정상 과정입니다. 중요한 건 에러 메시지를 잘라내지 말고 전부 붙여넣는 것입니다. 마지막 몇 줄만 주면 AI도 못 찾습니다.
저장이 막힐 때
이 단계에서 막히는 건 아주 흔합니다. "메모장으로 저장했는데 뒤에 .txt가 붙어요" 같은 말이면 충분합니다. 그 상태를 그대로 말하면 AI가 맞춰줍니다.
코드는 AI가 만듭니다. 지금은 누구나 그렇게 할 수 있어요. 하지만 무엇을 만들라고 시킬지는 AI가 정해주지 않습니다.
어떤 소재를 버릴지, 기준값을 얼마로 둘지, 성공을 무엇으로 판정할지, 무엇을 재고 무엇을 재지 않을지, 어디서 돈이 나오는지. 이 책이 파는 건 그 판단이고, 몇 달을 굴려야 나오는 것들입니다. 연두색 상자에는 그 판단이 전부 문장으로 들어가 있습니다.
전략 — 어디서 돈이 나오나
기술보다 이게 먼저입니다. 돈이 나오는 구멍을 먼저 정해야 무엇을 쓸지가 정해집니다.
전략 1
수익 모델 지도
블로그로 돈이 되는 길은 크게 셋입니다. 셋의 성격이 완전히 다릅니다.
| 모델 | 돈이 나오는 방식 | 필요한 것 | 시작 난이도 |
|---|---|---|---|
| 광고 | 글에 광고가 붙고, 노출·클릭만큼 | 운영 기간과 심사 통과 | 쉬움 (심사만 통과하면) |
| 제휴 | 내 링크로 누가 사면 수수료 | 제휴 프로그램 가입 | 보통 |
| 자체 상품 | 내가 만든 걸 직접 판매 | 만들 것과 결제 수단 | 어려움 (다만 이익률 최고) |
광고 — 가장 먼저, 가장 작게
글에 광고를 붙이는 방식입니다. 가장 손이 덜 가지만 단가가 낮습니다. 조회수가 크게 나야 의미 있는 금액이 됩니다.
광고 심사에는 운영 기간이 걸립니다. 대체로 몇 달 단위입니다. 그리고 수익은 평균값이 아니라 터지는 글 하나에 몰립니다. 그래서 심사는 글이 터지기 전에 통과시켜 둬야 합니다. 터진 뒤에 신청하면 승인을 기다리는 며칠 사이에 트래픽이 다 죽습니다.
그리고 심사에는 보통 재신청 횟수 제한이 있습니다. "일단 넣어보고 안 되면 또"는 금물입니다. 조건을 채우고 한 번에 넣으세요.
공식 기준은 대개 "운영 기간·방문자·콘텐츠 적합성 종합 평가"처럼 두루뭉술합니다. 실제로 걸리는 건 광고성 글의 비중입니다. 협찬·홍보 글이 내 글보다 많으면 떨어집니다. 심사 전에 그 비율을 정리하세요.
제휴 — 이 책이 권하는 자리
내 링크로 누가 사면 수수료를 받습니다. 광고보다 건당 금액이 크고, 무엇보다 조회수가 적어도 됩니다. 살 마음이 있는 사람 열 명이 대충 보는 천 명보다 낫습니다.
이 책의 판정 방식이 제휴와 특히 잘 맞습니다. 승산 게이트가 골라내는 건 결정 직전에 치는 검색어이기 때문입니다.
자체 상품 — 나중에
이익률은 최고지만 만들 것이 있어야 하고, 결제를 붙이려면 사업자 등록과 통신판매업 신고가 필요합니다. 앞의 둘로 트래픽 구조를 만든 뒤에 얹는 순서를 권합니다.
전략 2
제휴 프로그램 고르기
제휴는 종류가 많습니다. 고르는 기준을 먼저 정하고, 그 기준으로 훑으세요.
고르는 기준 다섯
- 가입 문턱. 심사가 없는 곳도, 채널 실적을 보는 곳도 있습니다. 시작 단계에는 문턱이 낮은 곳부터.
- 출금 벽. 최소 출금액입니다. 이게 제일 자주 발목을 잡습니다. 뒤에서 따로 다룹니다.
- 가격대. 수수료율보다 중요합니다. 독자가 그 자리에서 결제할 수 있는 금액이어야 합니다.
- 쿠키 기간. 내 링크를 누른 뒤 며칠 안에 사야 내 실적이 되는지. 짧으면 즉시 구매만 잡힙니다.
- 실적 귀속. 링크를 발급한 계정에 붙는지, 게시한 채널에 붙는지. 모르고 붙이면 몇 주치가 사라집니다.
국내에서 실제로 쓸 수 있는 것들
| 종류 | 성격 | 가입 문턱 | 가격대 |
|---|---|---|---|
| 종합 쇼핑몰 제휴 | 거의 모든 상품에 링크를 걸 수 있음. 요율은 낮고 고정에 가까움 | 낮음. 심사가 형식적인 편 | 전 구간 |
| 포털 쇼핑 제휴 | 판매자가 요율을 정하는 구조라 편차가 큼. 에디터에서 바로 링크를 넣을 수 있는 곳도 있음 | 낮아지는 추세. 운영 중인 채널이면 대체로 가능 | 전 구간 |
| 제휴 중개 플랫폼 | 여러 브랜드를 한 계정에서 관리. 여행·숙박·교육 등 카테고리별로 다양 | 보통 | 중·고가 |
| 브랜드 직접 제휴 | 한 브랜드와 직접. 요율이 제일 좋지만 실적을 요구 | 높음 | 브랜드에 따라 |
브랜드마다 따로 가입하면 최소 출금액도 각각 쌓아야 합니다. 시작 단계 트래픽으로는 어느 벽도 못 넘고 한 푼도 못 받습니다. 열 곳에 5만원씩 흩어져 있으면 50만원을 벌고도 0원입니다.
그래서 여러 브랜드를 한 계정으로 묶어 합산 출금해 주는 중개 플랫폼이 시작 단계에는 유리합니다. 요율이 조금 낮아도 받을 수 있는 돈이 받지 못하는 돈보다 큽니다. 실적이 쌓인 뒤에 직접 제휴로 갈아타면 됩니다.
우리는 수수료가 큰 상품만 골라서 다뤘습니다. 결과는 클릭 115에 주문 0이었습니다. 200만원대 제품이었어요. 블로그 글을 읽다가 그 자리에서 200만원을 결제하는 사람은 없습니다.
전환을 가르는 건 수수료율이 아니라 결제까지의 거리입니다. 10~30만원대가 그 거리가 짧습니다. 요율이 절반이어도 주문이 나면 이깁니다.
가입 전에 확인할 것 — 이것도 시키세요
블로그에 붙일 제휴 프로그램을 고르려고 해. 나는 이제 시작하는 단계야.

내가 다루려는 주제는 (여기에 적으세요. 예: 생활가전 / 국내 숙소 / 육아용품) 야.

아래를 표로 정리해 줘. 공식 페이지 기준으로 확인하고,
확실하지 않은 항목은 "확인 필요" 라고 표시해 줘. 추측으로 채우지 마.

1) 이 주제에 쓸 수 있는 제휴 프로그램 목록
2) 각각의 가입 조건 (심사가 있는지, 채널 실적을 요구하는지, 사업자가 필요한지)
3) 수수료 방식 (고정인지 판매자가 정하는지, 대략의 범위)
4) 최소 출금액과 정산 주기
5) 쿠키 기간 (링크를 누른 뒤 며칠 안에 사야 내 실적이 되는지)
6) 실적이 링크 발급 계정에 붙는지, 게시한 채널에 붙는지
7) 대가성 문구 표기 의무가 어떻게 되는지

그리고 마지막에, 시작 단계에서 어디부터 붙이는 게 좋을지
"출금 벽" 과 "가격대" 기준으로 하나를 추천하고 이유를 세 줄로 알려줘.
대가성 고지
- 고지는 글 맨 앞에 둡니다. 뒤에 숨기면 그게 더 큰 문제가 됩니다.
- 에디터가 링크 삽입 기능을 제공하고 문구를 자동으로 넣어 주는 경우가 있습니다. 그 경우 직접 링크를 붙이는 것보다 그 기능을 쓰는 게 안전합니다.
- 문구가 사실과 어긋나지 않게 하세요. 그 사람이 쓴 그 물건이 아니라 비슷한 종류라면, 그렇게 써야 합니다. 여기서 말이 틀어지면 허위 광고가 됩니다.
전략 3
무엇을 다룰지 — 축 고르기
축은 주제 분류가 아니라 판정 기준의 묶음입니다. 목적이 다르면 다른 축입니다.
세 가지 축의 성격
| 축 | 목적 | 소재 단위 | 돈 | 시작 시점 |
|---|---|---|---|---|
| 이슈 | 유입을 끌어온다 | 사건 하나 | 광고. 단가 낮음 | 제일 먼저 |
| 상품 | 제휴 수익 | 상품 하나 | 제휴 수수료 | 이슈축이 돌기 시작하면 |
| 장소·서비스 | 제휴 수익 2호 | 고유명 하나 | 제휴 수수료 | 상품축이 가격대에 막히면 |
왜 이 순서인가
이슈축은 돈이 거의 안 됩니다. 그런데 먼저 합니다. 여기서 쌓이는 지수가 뒤의 두 축이 순위를 받는 조건이기 때문입니다. 신생 계정으로 처음부터 수익 축만 하면 순위가 안 나서 아무 일도 안 일어납니다.
상품축은 수익이 나지만 가격대 벽이 있습니다. 큰 금액대 상품만 다루면 클릭은 나는데 주문이 안 납니다. 그때 세 번째 축이 필요해집니다 — 결제 거리가 짧은 자리요.
- 이 축의 목적이 트래픽인가 수익인가 (검색량·비율 기준이 달라집니다)
- 소재의 단위가 무엇인가 (앵커 뽑는 방식이 정해집니다)
- 독자가 검색으로 오나 추천 피드로 오나 (제목 규칙이 정반대가 됩니다)
- 의도 어휘가 고정되나 (고정되면 의도 확인 층을 걸 수 있습니다)
하나만 고른다면
처음이라면 이슈축 하나로 4주를 권합니다. 이유는 셋입니다.
- 제휴 가입 심사를 기다리는 동안에도 진행됩니다.
- 소재가 매일 새로 생겨서 파이프라인이 마를 일이 없습니다.
- 승산 게이트의 효과가 가장 빨리 눈에 보입니다. 롱테일이 실제로 순위를 받거든요.
4주 뒤 유입이 붙기 시작하면 그때 수익 축을 얹습니다. 축을 늘릴 때 무엇을 같이 늘려야 하는지는 26장에 있습니다.
축이 늘면 발행량이 늘고 싶어집니다. 참으세요. 우리는 상한을 풀었다가 구독자 서른 명도 안 되는 계정에 하루 13편을 낸 적이 있습니다. 그날 밤에 나간 셋의 조회수는 0, 1, 1이었고 낮에 나간 건 1,460이었습니다.
축을 늘릴 때는 총량을 그대로 두고 나눕니다. 새 축은 기존 축의 자리를 뺏어야 합니다.
여기까지 정했으면
이제 만들 차례입니다. 1부부터 순서대로 읽으시거나, 급하면 부록 F의 지시문을 순서대로 복사하세요. 어느 쪽이든 첫 결과물이 나가는 데까지 며칠이면 됩니다.
결과물과 구조
말로만 하면 감이 안 옵니다. 실제로 나간 것과 전체 구조를 먼저 보고 가세요.
보기 1
실제로 이렇게 나갑니다
아래는 이 책의 방식으로 사람 손 없이 발행된 글입니다. 계정을 알아볼 수 있는 부분만 가렸고, 본문은 손대지 않았습니다.
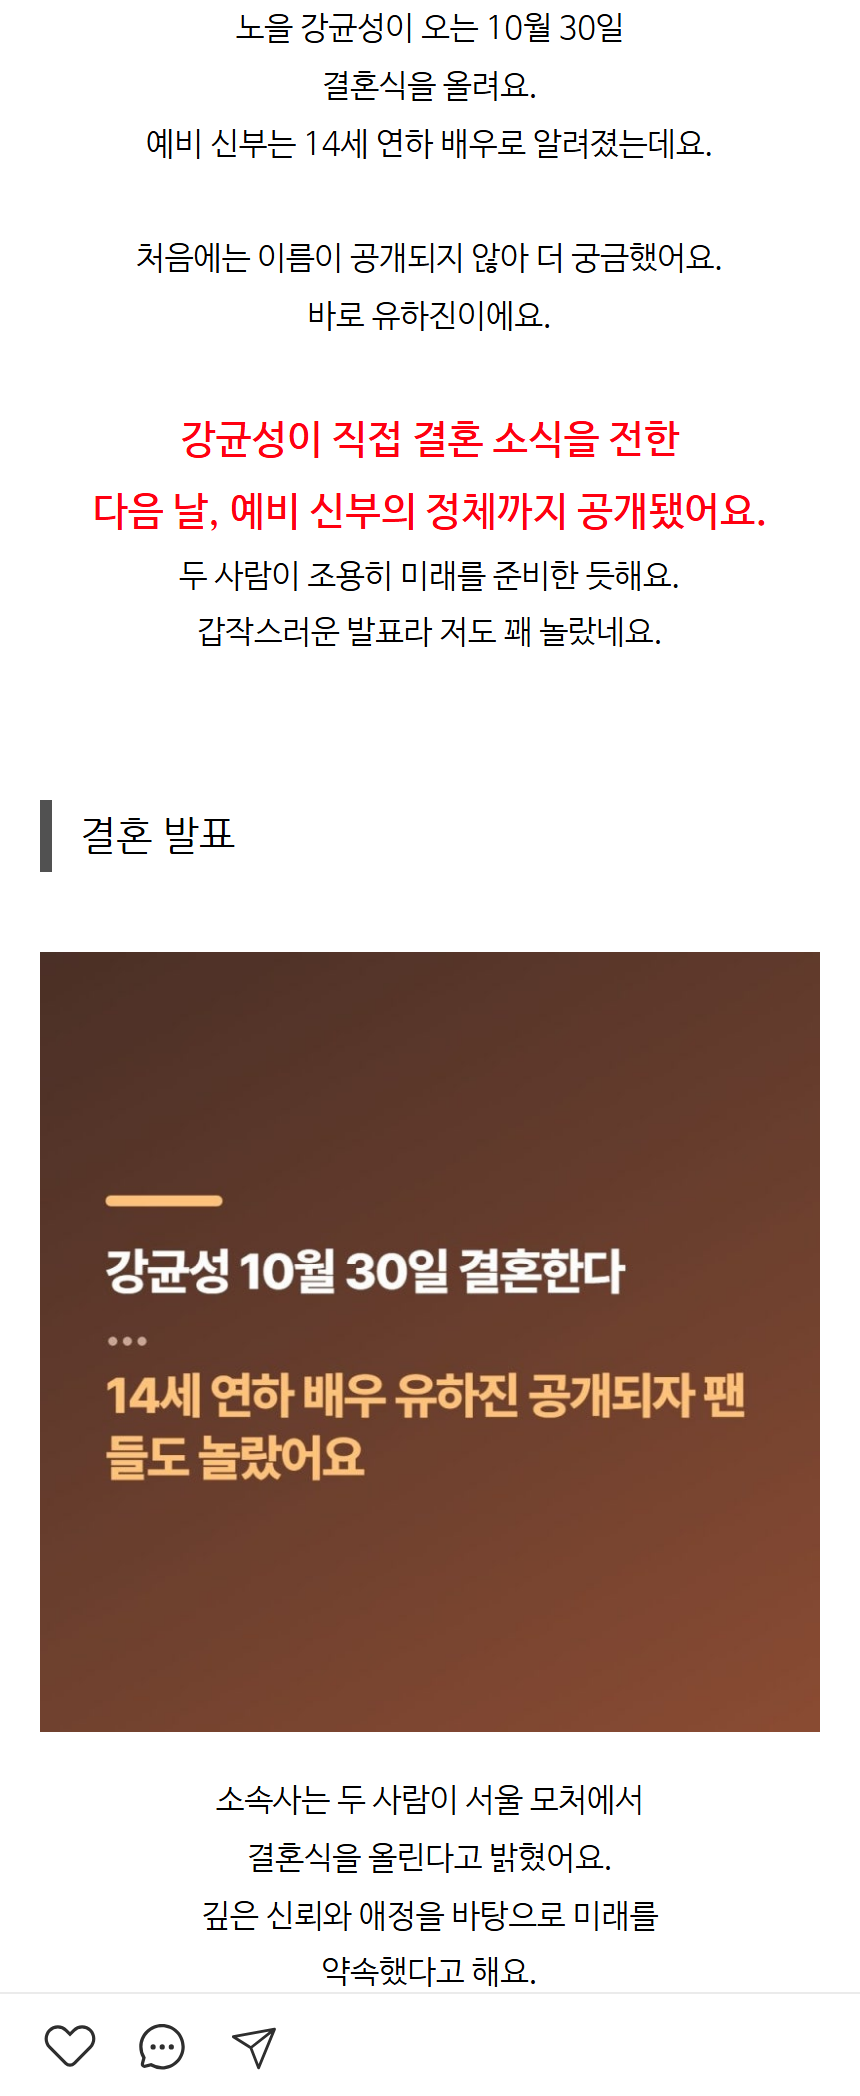
- 줄 길이 한 줄이 20자 안쪽입니다. 모바일에서 눈이 안 아픕니다. 이 값은 잘 되는 곳 40건을 재서 나온 것입니다(9장).
- 정렬 문단이 가운데입니다. 벤치마크 실측 94%가 이 형태였습니다.
- 블록 3~4줄마다 빈 줄로 끊습니다. 통짜 문단은 스크롤로 읽히지 않습니다.
- 강조 빨강이 두 줄. 규격은 1~3곳입니다. 많으면 싸구려로 보입니다.
- 소제목 인용구 형태에 숫자가 없습니다. 벤치마크에서 숫자 사용률이 0%였습니다.
- 이미지 정보 카드가 블록 사이에 들어갑니다. 끝에 몰리면 안 읽힙니다(14장).
이 모양이 매번 똑같이 나온다는 게 핵심입니다. 사람이 쓰면 컨디션에 따라 달라지고, 달라지면 무엇이 효과였는지 영원히 알 수 없습니다. 규격을 파일 하나로 못 박았기 때문에 이 글과 다음 글의 차이가 측정 가능한 한 가지가 됩니다. 그게 6부 학습의 전제입니다.
보기 2
전체 구조 한 장
보기 3
승산이라는 개념 — 그림 하나로
보기 4
깔때기 — 48건이 2건이 되기까지
보기 5
병목은 위에서부터 봅니다
보기 6
수익화에 대해 — 미리 말씀드립니다
이 책은 파이프라인을 만드는 법을 알려줍니다. 얼마를 벌지는 알려주지 않습니다. 그건 알 수 없는 영역이기 때문입니다.
정직하게 적습니다
이 책에는 수익 보장이 없습니다. 얼마를 번다는 숫자도 없습니다. 그건 주제, 시기, 계정 나이, 경쟁 상황, 그리고 무엇보다 읽는 분의 전략과 실행에 달려 있습니다. 같은 도구를 줘도 결과가 크게 갈리는 게 이 분야입니다.
이 책이 줄 수 있는 건 셋입니다. 못 이길 자리를 미리 걸러내는 판정, 사람 없이 매일 도는 구조, 그리고 무엇이 효과였는지 알 수 있게 만드는 측정. 그 위에 무엇을 얹을지는 여러분의 몫입니다.
이 책이 하는 것
어디에 쓰면 안 되는지 숫자로 걸러줍니다. 우리가 두 주를 버린 자리를 여러분은 첫날에 지나갑니다.
이 책이 못 하는 것
주제를 대신 골라주지 않습니다. 여러분이 아는 분야, 오래 볼 수 있는 분야여야 합니다.
시간이 걸리는 것
계정이 신뢰를 얻는 데는 시간이 듭니다. 광고 심사에도, 순위가 붙는 데도. 한 달 안에 판가름 나지 않습니다.
빨리 알 수 있는 것
내가 고른 소재가 이길 자리인지는 글을 쓰기 전에 알 수 있습니다. 그게 이 책의 4~8장입니다.
- 자동으로 돈이 들어온다. 자동으로 도는 건 발행이지 수익이 아닙니다. 수익은 고른 자리와 붙인 제휴가 만듭니다.
- 많이 쓰면 많이 번다. 하루 13편을 낸 날의 조회수가 0·1·1이었습니다. 물량은 답이 아닙니다.
- 한 번 만들면 끝이다. 플랫폼은 화면과 정책을 바꿉니다. 5부 자가복구가 그래서 있습니다.
손으로 하면 하루 한 편이 한계고, 그 한 편이 이길 자리인지도 모른 채 씁니다. 구조를 만들면 고르는 일에 시간을 쓰게 됩니다. 쓰는 일은 기계가 하고요.
그리고 무엇이 효과였는지 알게 됩니다. 그게 쌓이면 다음 판단이 빨라집니다. 이 책의 값어치는 벌어들일 금액이 아니라 줄어드는 시행착오에 있습니다.
판을 이해한다
코드를 쓰기 전에 무엇을 만드는지 정합니다. 1부를 건너뛰면 3부부터 이유를 모른 채 따라 하게 됩니다.
CHAPTER 1
두 달 뒤에 멈추는 이유
자동 발행은 어렵지 않습니다. 주말 하나면 만듭니다. 어려운 건 그게 두 달 뒤에도 살아 있는 겁니다.
멈추는 방식은 대개 셋 중 하나입니다.
- 조용히 죽습니다. 사이트가 화면을 바꾸거나, 프로세스가 죽은 락을 물고 있거나, 스케줄러가 재부팅 때 그날 것을 건너뜁니다. 에러는 안 납니다. 며칠 뒤에 압니다.
- 돌긴 도는데 아무도 안 봅니다. 이게 더 흔하고 더 아픕니다. 매일 성실하게 결과물이 나가는데 유입이 0에 수렴합니다. 만드는 층만 있고 무엇을 만들지 판정하는 층이 없어서입니다.
- 고칠 근거가 없습니다. 뭔가 잘 안 되는 건 아는데 어디를 고칠지 모릅니다. 재고 있는 게 없거나, 재고는 있는데 그 값이 다음 결과물에 아무 영향을 못 줍니다.
그래서 이 책은 파이프라인을 네 층으로 나눠 만듭니다. 흔히 만드는 건 두 번째 층 하나입니다.
| 층 | 하는 일 | 없으면 | 이 책 |
|---|---|---|---|
| 판정 | 만들 가치가 있는지 먼저 가른다 | 매일 만드는데 아무도 안 온다 | 2부 |
| 생성 | 규격에 맞는 결과물을 만든다 | 모양이 매번 달라 학습이 안 된다 | 3·4부 |
| 측정 | 나간 뒤 무슨 일이 있었는지 잰다 | 감으로 고치게 된다 | 6부 |
| 집행 | 잰 값이 다음 규격을 바꾼다 | 대시보드만 예뻐진다 | 6부 |
이 책이 다루는 것과 안 다루는 것
다루는 것은 구조입니다. 어떤 플랫폼에 무엇을 올리든 같은 뼈대가 나옵니다. 예제는 텍스트 콘텐츠 발행으로 잡았지만, 판정·규격·측정·학습은 이미지든 영상이든 상품 등록이든 그대로 갑니다.
발행 층은 4.5부에서 실제로 돌아가는 데까지 다룹니다. 브라우저를 띄우고, 로그인을 한 번만 하고, 에디터에 문서를 주입하고, 카테고리·태그·예약을 붙이고, 내보낸 뒤 성공을 판정하는 것까지. 이 책만으로 첫 글이 나가야 한다고 봤습니다.
다만 화면 좌표를 클릭하는 방식은 다루지 않습니다. 그건 화면이 바뀌면 같이 죽는 지식이고, 우리가 이틀을 버리고 폐기한 방식입니다. 대신 이름이 바뀌어도 동작하는 찾는 방법을 적었습니다.
그리고 이 층은 정책적으로 민감합니다. 25장에서 정면으로 다룹니다. 발행을 손으로 하더라도 나머지 서른여덟 장은 그대로 유효합니다.
다수의 플랫폼이 운영정책에서 자동 프로그램 사용을 금지 항목으로 명시합니다. 제재는 보통 단계적입니다 — 노출 강등, 게시물 비공개, 기간 정지, 접근 제한. 공식 발행 API가 종료된 곳도 있습니다.
이 책은 그 사실을 숨기지 않고 25장에서 정면으로 다룹니다. 판단은 읽는 분이 하시되, 위험을 모른 채 하시지는 않게 적었습니다. 그리고 성과를 실제로 가르는 층은 발행이 아니라 판정과 학습이라는 것이 이 책 전체의 주장입니다.
이 책을 읽는 순서
처음이라면 순서대로 읽으세요. 이미 뭔가 돌리고 있다면 2부와 6부만 먼저 읽어도 됩니다. 그 둘이 "돌긴 도는데 안 되는" 상태를 푸는 부분입니다.
- 노란 상자는 함정입니다. 전부 실제로 밟은 것이고, 부록 A에 번호로 모아뒀습니다.
- 초록 상자는 실측입니다. 측정한 값과 그 값이 나온 조건을 적었습니다.
- 파란 상자는 기술입니다. 구현할 때 알아야 할 세부입니다.
- 코드는 그대로 복사해 쓸 수 있게 썼습니다. 외부 라이브러리는 최소로 씁니다 — 의존성이 하나 줄면 무인 실행에서 깨질 자리가 하나 줄어듭니다.
CHAPTER 2
하루 한 바퀴
파이프라인은 단계가 아니라 고리입니다. 끝이 처음으로 돌아오지 않으면 그건 자동화가 아니라 반복문입니다.
수집 ──▶ 판정 ──▶ 생성 ──▶ 조립 ──▶ 출고
 ▲                                    │
 │                                    ▼
학습 ◀── 진단 ◀────────────────── 측정

단계   하는 일                          산출물                 장
────────────────────────────────────────────────────────────────
수집   후보를 넉넉히 긁는다             candidates.json        4
판정   이길 수 있는 것만 남긴다         picked.json            5~8
생성   규격에 맞는 초안을 만든다        draft.json             12
검수   규격 위반을 기계로 잡는다        (통과/불통과)          13
조립   최종 형태로 붙인다               assembled.json         14
출고   내보낸다. 또는 예약한다          published.log          15~16
측정   조회·유입·반응을 잰다            metrics/inflow/stats   21
진단   무엇이 병목인지 가른다           diagnosis.json         22
학습   기준값·규격을 바꾼다             tuning.json 갱신       23
단계를 쪼개는 이유
한 덩어리 스크립트로 만들면 중간에서 실패했을 때 처음부터 다시 돌려야 합니다. 그러면 이미 내보낸 것이 두 번 나갑니다. 단계마다 결과를 파일로 떨구고 다음 단계는 그 파일을 읽게 하면, 실패한 단계만 다시 돌릴 수 있습니다.
비용도 다릅니다. 수집은 몇 초, 판정은 API 호출 몇 번, 생성은 모델 호출 하나로 수십 초에서 몇 분입니다. 제일 비싼 단계 앞에 제일 강한 관문을 둔다가 이 배치의 원리입니다. 판정이 생성보다 앞에 있는 이유가 그것입니다.
모든 단계는 같은 입력에 같은 출력을 내야 합니다. 그래야 실패한 단계만 다시 돌릴 수 있고, 디버깅할 때 어제 것을 재현할 수 있습니다.
이 성질을 깨는 건 대개 셋입니다 — 단계 안에서 현재 시각을 읽는 것, 난수를 쓰는 것, 외부 API 응답을 캐시 없이 그대로 쓰는 것. 시각과 난수는 파이프라인 맨 앞에서 한 번만 정해서 아래로 넘기고, API 응답은 캐시합니다.
내 프로젝트의 뼈대를 만들어 줘. 아래 구조 그대로.

auto/
  .env
  daily/  envkey.py  log.py  net.py  runctx.py  work/
  spec/
  data/

각 파일이 하는 일
- envkey.py : 설정 읽기. 환경변수 > .env > 기본값 순서.
              필요한 값이 없으면 배치 중간이 아니라 시작하자마자 멈추게.
- log.py    : 시각과 단계 이름을 붙여 화면과 파일에 동시에 기록.
              윈도우에서 한글이 안 깨지게 출력 인코딩을 UTF-8로 고정.
- net.py    : 외부 호출 공통층. 4xx 는 재시도하지 않고 429·5xx 만 재시도.
              요청 간격은 고정하지 말고 1.2~2.6초 사이에서 흔들기.
- runctx.py : 배치 아이디·날짜·난수 씨앗을 한 번만 정해 파일로 남기기.
              각 단계는 이 값을 읽어 쓴다. 그래야 어제 배치를 재현할 수 있다.

반드시 지킬 것
- 파이썬 표준 기능만. 설치가 필요한 라이브러리는 쓰지 않는다.
- 파일 이름을 표준 라이브러리와 겹치게 짓지 않는다
  (http, json, csv, time, types, select, token, parser, email, queue, random).
- .env 에는 키 이름만 빈 값으로 만들어 준다. 값은 내가 직접 넣는다.
- 파일을 저장할 때는 임시 파일에 쓰고 바꿔치기하는 방식으로.

마지막에
- 각 파일을 어느 폴더에 어떤 이름으로 저장하는지, 폴더 만드는 법부터
- 네 파일이 다 동작하는지 한 번에 확인하는 점검 파일과 실행 명령
- 성공했을 때 화면에 무엇이 나오는지
단계 사이의 계약
단계끼리 주고받는 파일의 형태를 미리 못 박아두면, 나중에 단계 하나를 통째로 갈아끼울 수 있습니다. 실제로 이 책의 6장 게이트는 처음에 없던 층인데, 계약이 있었기 때문에 수집과 생성을 안 건드리고 사이에 끼워 넣을 수 있었습니다.
candidates.json   [ { "title": str, "url": str, "source": str } ]
picked.json       [ { ...candidate, "keyword": str, "vol": int,
                      "docs": int, "ratio": float, "axis": str } ]
draft.json        { "title": str, "body": [str], "category": str,
                    "keyword": str, "axis": str, "variant": str }
assembled.json    { ...draft, "components": [ ... ], "assets": [str] }
published.log     한 줄에 하나: ISO시각 \t axis \t url \t title
draft.json처럼 고정된 이름으로만 쓰면 어제 무엇이 나갔는지 확인할 수 없습니다. 문제가 생겼을 때 재현이 불가능해요. 배치 아이디를 붙인 폴더에 쓰고, 고정 이름은 그 폴더를 가리키는 링크나 복사본으로 두세요. 디스크는 싸고 재현 불가능한 사고는 비쌉니다.
CHAPTER 3
환경과 공통 규약
여기서 정한 세 가지가 끝까지 갑니다. 폴더 구조, 설정을 읽는 방식, 로그를 남기는 방식.
폴더
설정 읽기
키는 .env 한 곳에만 둡니다. 코드에 박으면 언젠가 리포에 올라갑니다. 읽는 함수는 한 번만 만들고 전 모듈이 같은 걸 씁니다.
require()를 각 스크립트 맨 위에서 부르세요. 키가 없으면 즉시 종료됩니다. 이게 없으면 수집·판정을 다 하고 생성 단계에서 키가 없어 죽고, 그때까지 쓴 시간과 API 호출이 버려집니다. 실패는 최대한 앞으로 당깁니다.
로그
무인 실행에서 로그는 유일한 눈입니다. 그런데 대부분 print만 쓰다가 정작 문제가 생겼을 때 아무것도 못 찾습니다. 세 가지만 지키면 됩니다.
윈도우 기본 콘솔 인코딩은 cp949입니다. 한글이나 이모지가 섞인 출력에서 UnicodeEncodeError가 나고, 이미 성공한 작업이 실패로 기록됩니다. 발송은 끝났는데 호출부가 실패로 읽는 상황이 실제로 있었습니다.
지시문에 이 내용을 넣어 UTF-8을 고정하게 하고, 하위 프로세스를 부를 때도 encoding="utf-8", errors="replace"를 명시하세요.
HTTP — 재시도와 스로틀
외부를 부르는 코드는 전부 이 하나를 통과시킵니다. 그래야 재시도 정책과 요청 간격을 한 곳에서 바꿉니다.
이 파일을 http.py로 만들면 안 됩니다. http는 파이썬 표준 라이브러리 패키지 이름이고, 스크립트를 실행하면 그 폴더가 모듈 검색 경로 맨 앞에 옵니다. 그러면 urllib.request가 내부에서 http.client를 부르는 순간 전부 깨집니다.
실제로 이 책의 초고가 그 이름을 쓰고 있었습니다. 같은 함정이 있는 이름들 — json.py, csv.py, types.py, select.py, token.py, parser.py, email.py, queue.py, random.py, time.py. 공통 모듈에는 표준 라이브러리에 없는 이름을 쓰세요.
확인은 한 줄이면 됩니다. python -c "import http; print(http.__file__)"가 내 폴더를 가리키면 가려진 것입니다.
인증 실패나 잘못된 요청은 몇 번을 다시 보내도 같습니다. 재시도는 시간만 쓰고, 더 나쁘게는 차단 임계에 더 빨리 도달하게 합니다. 재시도는 429(과다 요청)와 5xx(서버 문제)에만 의미가 있습니다.
공통 규약 정리
- 설정은
.env한 곳, 읽기는envkey.env()하나 - 스크립트 맨 위에서
require()로 필요한 키를 확인하고, 없으면 즉시 종료 - 모든 출력은
Log를 통해서. 파일과 화면에 동시에 - 모든 외부 호출은
net.get()을 통해서. 재시도와 간격은 거기서만 바꾼다 - 시각과 난수는
runctx에서 한 번만 정한다 - 중간 산출물은 배치 폴더에 남긴다. 덮어쓰지 않는다
무엇을 만들지 정한다
이 책에서 가장 값나가는 부분입니다. 여기가 없으면 나머지 스물한 장이 전부 헛수고가 됩니다.
CHAPTER 4
후보를 모은다
수집은 쉬운 층입니다. 그래서 여기에 시간을 쓰면 안 됩니다. 지켜야 할 건 두 개뿐입니다.
하나 — 넉넉히 모은다
다음 장의 게이트가 후보의 7~8할을 떨어뜨립니다. 실측으로 48건 수집에 13건 통과였습니다. 하루 2건을 내보낼 거라면 수집은 40건 이상이어야 합니다.
| 단계 | 건수 | 비고 |
|---|---|---|
| 수집 | 48 | 수집처 4곳 |
| 게이트 통과 | 13 | 27% |
| 실제 출고 | 2 | 상한 관문 적용 |
통과분이 출고량보다 훨씬 많아야 합니다. 딱 맞게 통과하면 수집이 하루라도 흔들리는 날 축이 통째로 빕니다.
수집처는 어디서 구하나
지시문에 "RSS 주소 목록"이라고 나오는데, 그 주소를 어디서 얻는지부터 막힐 수 있습니다.
RSS는 사이트가 새 글 목록을 기계가 읽기 좋게 내주는 주소입니다. 대부분의 언론사와 블로그가 갖고 있고, 보통 주소 끝에 /rss 나 /feed 를 붙이면 나옵니다. 브라우저로 열었을 때 꺾쇠와 글자가 잔뜩 있는 화면이 나오면 맞는 주소입니다.
내 블로그 주제는 (여기에 적으세요) 야.
매일 새 소재를 얻을 수 있는 RSS 주소를 찾아줘.

조건
- 하루에 새 글이 여러 건 올라오는 곳
- RSS 가 실제로 열리는 곳 (막아둔 곳이 많으니 확인해줘)
- 서로 다른 성격으로 4~6곳
- 한국어 사이트

각각에 대해 알려줘
1) 사이트 이름
2) RSS 주소
3) 하루에 몇 건쯤 올라오는지
4) 이 주제에 맞는 이유 한 줄

그리고 그 주소들이 진짜로 열리는지 확인하는 방법도 알려줘.
브라우저로 열었을 때 어떻게 보이면 맞는 건지.
둘 — 한 곳이 죽어도 계속 간다
daily/collect.py 를 만들어 줘. 후보를 모아 파일로 남기는 단계야.

- RSS 주소 목록을 파일 위쪽에 두고, 내가 나중에 바꿀 수 있게 해줘
- 수집처마다 따로 예외 처리해서, 한 곳이 죽어도 나머지는 계속 진행되게
- 몇 곳이 실패했는지 반드시 로그에 남기게 (조용한 실패가 제일 위험해)
- ⚠️ 인코딩 처리를 꼭 넣어줘. 한국 뉴스 RSS 는 UTF-8 이 아닌 곳이 많아서
  그냥 파싱하면 "not well-formed" 오류가 난다. XML 선언에 적힌 인코딩을
  먼저 보고, 그래도 실패하면 euc-kr 과 cp949 로 다시 시도해줘
- 제목 앞 14글자로 중복을 판정 (전체 문자열로 비교하면 다 통과해버려)
- 앞서 만든 net.get 과 log.Log, runctx.ctx 를 그대로 쓰기
- 결과를 work/(배치아이디)/candidates.json 에 저장하고,
  work/latest_candidates.json 에도 같은 내용을 하나 더 남겨 줘
  (나중에 만들 감시 기능이 고정된 위치를 봐야 해)
- 한 건도 못 모으면 종료코드 4 로 끝내서 뒤 단계가 헛돌지 않게

실행 명령과 성공했을 때 화면도 알려줘.
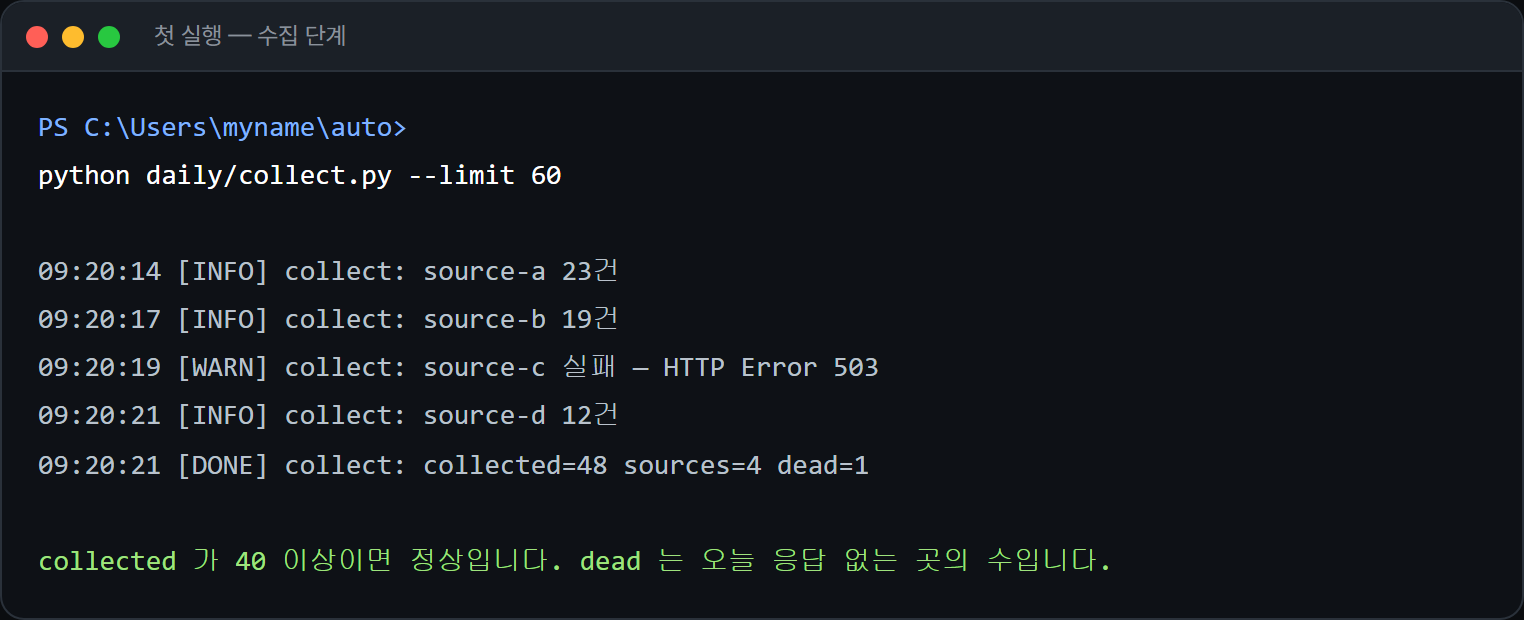
예외를 안 잡으면 수집처 하나가 응답을 안 하는 날 배치가 통째로 멈춥니다. 그날 출고는 0건인데 아무도 모릅니다. 수집처마다 감싸되 몇 곳이 죽었는지는 반드시 남기세요. 조용한 실패가 제일 비쌉니다.
같은 사건을 다루는 글이라도 매체마다 제목이 조금씩 다릅니다. 전체 문자열로 비교하면 전부 다른 것으로 보고 같은 소재를 여러 번 만듭니다. 앞 N자로 자르거나, 핵심 낱말 집합으로 비교하세요. 지시문에서는 14자를 쓰게 했는데, 이 값은 주제에 따라 조정하시면 됩니다.
실제로 돌려보면 첫날 통과가 0건인 경우가 흔합니다. 그때 제일 먼저 볼 것은 게이트가 아니라 수집처입니다.
저희가 이 책을 검증하면서 12건을 판정했더니 0건 통과가 나왔습니다. 게이트가 고장 난 줄 알았는데, 수집처 주소를 잘못 골라 경제·증시 뉴스가 들어와 있었습니다. 이슈 축 기준으로는 전부 떨어지는 게 맞는 동작이었어요.
순서대로 확인하세요. ① 수집된 제목을 눈으로 열어보고 내 주제가 맞는지 ② 그 중 하나를 골라 게이트를 직접 돌려보기 ③ 그래도 0이면 기준값을 한 칸씩 완화.
판정을 돌렸는데 통과한 게 0건이야. 원인을 순서대로 찾아줘.

1) 수집된 제목 20개를 보여줘. 내 주제와 맞는 글들인지 내가 볼게
2) 그 중 하나를 골라 게이트를 단독으로 돌려서,
   각 후보 낱말이 어느 조건에서 떨어졌는지 하나씩 보여줘
   (검색량 미달인지, 문서수 초과인지, 비율 미달인지, 기기 비중인지)
3) 조건별로 몇 건씩 떨어졌는지 집계해줘

집계를 보고 어느 기준을 얼마나 조정할지 제안해줘.
한 번에 하나만 바꾸자.
CHAPTER 5
승산이라는 개념
이 장 하나만 가져가셔도 됩니다. 우리는 이걸 몰라서 두 주를 버렸습니다.
일어난 일
블로그를 열고 13일 동안 결과물 30개를 냈습니다. 유입이 거의 없어서 색인 문제인 줄 알았습니다. 확인해보니 색인은 정상이었어요. 최근 8건을 제목 그대로 검색하니 7건이 나왔습니다. 그런데 사람들이 실제로 치는 검색어로 찾으니 8건 중 0건이었습니다.
색인은 됐는데 순위가 없었던 겁니다. 원인은 하나였습니다. 소재를 화제성으로만 골랐던 것.
에어프라이어 추천     646,794건   ← 우리가 노리던 급
식기세척기 추천       456,904건
국내여행지추천        225,784건
언더싱크정수기 가격     7,236건   ← 문서는 적은데 검색이 월 20
송혜교 보브컷           1,010건   ← 여기는 실제로 승산이 있다
효연 결별                 714건
화제성 1위 소재는 정의상 모두가 쓰는 자리입니다. 13일 된 계정이 이길 수 없어요. 반대로 롱테일은 문서가 천 건대라 신생도 1페이지에 들어갑니다.
수요와 경쟁은 반드시 같이 본다
위 표에서 언더싱크정수기 가격을 보세요. 문서가 7,236건이라 경쟁은 약합니다. 그런데 검색량이 월 20입니다. 1위를 해도 아무도 안 옵니다.
경쟁만 피하면 아무도 안 찾는 자리에 도착합니다. 이게 이 층에서 가장 흔한 실패입니다. 그래서 지표를 하나로 묶습니다.
승산 비율 = 월간 검색량 ÷ 블로그 문서수

  비율이 크다 = 찾는 사람에 비해 쓴 사람이 적다 = 우리 자리
  비율이 작다 = 찾는 사람보다 쓴 사람이 많다   = 재고와 싸운다

예)  30,240 ÷  1,381 = 21.90   ← 채택
     16,270 ÷ 646,809 = 0.025  ← 탈락
         20 ÷  7,236  = 0.003  ← 탈락 (수요 자체가 없다)
비율 하나만으로는 부족합니다. 비율이 커도 검색량이 월 30이면 의미가 없거든요. 그래서 하한 셋을 같이 겁니다.
| 지표 | 역할 | 없으면 생기는 일 |
|---|---|---|
| 월간 검색량 하한 | 1위를 했을 때 실제로 사람이 오는가 | 월 50짜리 키워드가 통과한다 |
| 문서수 상한 | 1페이지에 물리적으로 들어갈 수 있는가 | 10년치 재고와 싸운다 |
| 비율 하한 | 수요 대비 경쟁이 유리한가 | 큰 키워드가 검색량만으로 통과한다 |
| 모바일 비중 하한 | 검색하는 사람이 내 독자인가 | 업무용 검색어를 잡는다 (7장) |
경쟁도를 어디서 읽나
검색광고 API는 경쟁도 지표(낮음·중간·높음)를 같이 줍니다. 편해 보이지만 그건 광고 입찰 경쟁도지 콘텐츠 경쟁도가 아닙니다. 인물명·작품명은 광고주가 없어서 전부 '낮음'으로 나옵니다. 이걸 믿으면 레드오션 키워드를 전부 통과시킵니다.
콘텐츠 경쟁도는 그 키워드로 이미 쓰인 문서의 수 하나입니다. 검색 API의 전체 건수를 쓰세요.
기준값은 축마다 다르다
8장에서 자세히 다루지만 미리 말해둡니다. 같은 게이트를 모든 축에 쓰면 안 됩니다. 조회 1건의 값이 축마다 다르기 때문입니다.
| 축 | 검색량 하한 | 문서수 상한 | 비율 하한 | 이유 |
|---|---|---|---|---|
| 트래픽 축 | 500 | 20,000 | 0.1 | 양이 중요. 조회 1건의 값이 작다 |
| 수익 축 | 300 | 60,000 | 0.3 | 구매 의도라 1건의 값이 크다 |
CHAPTER 6
게이트 구현
API 둘을 붙이고, 캐시를 얹고, 판정을 만듭니다. 전부 표준 라이브러리로 씁니다.
검색량 — HMAC 서명이 필요한 API
검색광고 API는 요청마다 서명을 요구합니다. 서명 문자열이 타임스탬프.메서드.경로이고 쿼리스트링은 넣지 않는다는 게 포인트입니다. 여기서 대부분 막힙니다.
소재가 이길 수 있는 자리인지 판정하는 기능을 만들어 줘.
파일 네 개로 나눠 줘: keyword_tool.py, docs_count.py, cache.py, kw_gate.py

[keyword_tool.py] 월간 검색량과 기기 비중
- 검색 광고 API 는 HMAC-SHA256 서명이 필요해
- 서명 문자열은 "타임스탬프.메서드.경로" 이고, 쿼리스트링은 넣지 않아
  (여기서 대부분 막혀. 꼭 지켜줘)
- 응답에 "< 10" 같은 문자열이 섞여 와. 0 이 아니라 최소 표시값이니
  10 으로 처리해. 0 으로 읽으면 멀쩡한 후보가 다 탈락해
- 공백이 든 키워드는 이 API 가 오류를 내니까 공백을 붙여서 보내
- 실패하면 예외를 던지지 말고 빈 값을 돌려주고 로그만 남겨.
  판정 기능의 실패가 전체를 멈추면 안 돼

[docs_count.py] 그 키워드로 이미 쓰인 문서 수
- 검색 오픈 API 로 전체 건수만 가져와. display=1 이면 충분해
- 못 재면 0 이 아니라 -1 을 돌려줘 (모르는 것과 없는 것은 달라)
- 상위 10건 제목만 따로 가져오는 함수도 같이 만들어 줘

[cache.py] 같은 걸 두 번 묻지 않게
- 결과를 24시간 보관하는 아주 단순한 파일 캐시
- 저장할 때는 임시 파일에 쓰고 바꿔치기해 줘.
  쓰다가 멈추면 반쯤 쓰인 파일이 남아서 다음에 못 읽어

[kw_gate.py] 판정 본체
- 기준값은 코드에 박지 말고 daily/tuning.json 에서 읽어 줘.
  나중에 성과를 보고 이 값을 자동으로 조정할 거라서 파일이어야 해
- tuning.json 초기값:
    issue 축: 검색량 500 이상, 문서수 20000 이하, 비율 0.1 이상, 모바일 0.6 이상
    money 축: 검색량 300 이상, 문서수 60000 이하, 비율 0.3 이상, 모바일 0.6 이상
- 비율 = 월간 검색량 ÷ 문서 수. 이게 승산 지표야
- 통과한 것 중 비율이 가장 높은 것 하나를 고르게
- 문서수를 못 잰 경우(-1)는 탈락이 아니라 통과로 처리해
- 후보 낱말은 최대 6개까지만 본다. 많이 볼수록 정확해지지 않고 느려지기만 한다
- 후보 하나를 판정할 때마다 한 줄씩 로그를 찍어줘.
  몇 분씩 조용하면 멈춘 줄 알게 된다

API 가 주는 경쟁도 지표는 절대 쓰지 마. 그건 광고 경쟁도라
인물 이름은 전부 '낮음' 으로 나와서 판정이 망가져.
daily/anchor.py 를 만들어 줘. 제목에서 검색어가 될 낱말을 뽑는 기능이야.

- 따옴표 안을 먼저 보면 안 돼. 예를 들어 〈"같은 사람 맞아?" 송혜교〉 에서
  '같은' 이 뽑히는 사고가 나. 따옴표 구간을 통째로 지우고 바깥에서 먼저 찾고,
  바깥이 비었을 때만 안을 봐
- 조사·수식어 같은 검색어가 안 되는 말은 목록으로 걸러 줘
- 협회·재단·공단·연구원처럼 기관 이름으로 끝나는 낱말은 후보에서 빼 줘
  (그 기관이 뭔지 답하는 자리라 우리 글이 답이 될 수 없어)
- 한 낱말과 두 낱말 조합을 같이 만들어 줘
- 선정성·명예훼손이 될 만한 낱말이 제목에 있으면 아예 빈 목록을 돌려줘.
  숫자 판정은 이런 걸 못 걸러내니까 여기서 먼저 막아야 해
두 낱말을 띄어 쓴 조합 키워드를 넣으면 이 API가 오류를 냅니다. 그런데 코드가 예외를 삼키면 검색량 0으로 보입니다. 0이 아니라 못 잰 것입니다. 이 둘을 구분하지 않으면 멀쩡한 후보가 조용히 전멸합니다. 공백은 붙여서 넣으세요.
검색량이 아주 적으면 숫자 대신 < 10 같은 문자열이 옵니다. 정수 변환에 실패해 0으로 떨어뜨리면 실제로는 있는 수요를 없는 것으로 봅니다. 위 _num처럼 명시적으로 처리하세요.
문서수 — 진짜 경쟁도
캐시 — 같은 걸 두 번 묻지 않는다
후보 48건에 앵커가 각각 여러 개면 API 호출이 수백 번이 됩니다. 같은 키워드는 하루 안에 값이 거의 안 변하므로 캐시합니다. 이건 비용 문제가 아니라 차단을 피하는 문제이기도 합니다.
임시 파일에 쓰고 replace로 바꾸는 패턴을 기억하세요. 파일을 직접 열어 쓰다가 프로세스가 죽으면 반쯤 쓰인 JSON이 남고, 다음 실행에서 파싱 에러가 납니다. 캐시·장부·상태 파일 전부 이 방식으로 씁니다.
앵커 뽑기
사람들은 제목 전체를 검색하지 않습니다. 그 안의 핵심 낱말을 칩니다. 그래서 제목에서 검색어가 될 후보를 먼저 뽑아야 합니다.
"같은 사람 맞아?" 송혜교에서 앵커로 '같은'이 잡히고, '건강 악화' 아이유에서는 '건강악화'가 잡힙니다. 둘 다 검색되지 않는 말입니다. 인용문은 기사 제목에서 눈에 띄는 자리라 정규식으로 먼저 잡히기 쉬운데, 검색 관점에서는 가장 쓸모없는 구간입니다.
따옴표 구간을 통째로 지우고 바깥을 먼저 본 뒤, 거기서 못 찾을 때만 안을 봅니다.
게이트 본체
기준값은 코드에 박지 않습니다. 23장의 학습 층이 이 값을 조정하고 효과가 없으면 되돌려야 하기 때문입니다. 상수로 두면 사람이 매번 파일을 고쳐야 하고, 무엇보다 되돌릴 수가 없습니다.
{
  "issue": { "min_vol": 500, "max_docs": 20000, "min_ratio": 0.10, "min_mobile": 0.6 },
  "money": { "min_vol": 300, "max_docs": 60000, "min_ratio": 0.30, "min_mobile": 0.6 },
  "intent_min_hits": 6,
  "intent_top_n": 10
}
문서수를 못 잰 경우(-1)를 탈락이 아니라 통과로 처리한 것에 주목하세요. API가 잠깐 죽었다고 그날 배치가 전멸하면 안 됩니다. 판정 층의 실패는 파이프라인을 세우지 않는다가 규약입니다. 대신 로그에 남기고, 그런 날이 반복되면 19장의 가드가 잡습니다.
이 책을 검증하면서 재봤습니다. 후보 12건 판정에 약 5분이 걸렸습니다. 60건이면 20분이 넘습니다.
느린 이유는 요청 사이에 일부러 쉬기 때문입니다(3장의 스로틀). 이건 차단을 피하려고 넣은 것이라 줄이면 안 됩니다. 대신 캐시가 있어서 둘째 날부터는 훨씬 빨라집니다 — 같은 낱말은 다시 안 묻거든요.
그리고 이 시간은 새벽에 사람 없이 도는 시간입니다. 기다릴 일이 아닙니다. 처음 손으로 돌려볼 때만 길게 느껴집니다.
통과한 키워드는 반드시 쓴다
승산 키워드를 고른 뒤 생성 단계에 소재만 넘기면, 모델이 더 그럴듯한 제목을 만들면서 그 키워드를 빼버립니다. 고생해서 고른 자리를 놓치는 겁니다. 제목 앞부분에 그대로 들어가게 지시하고, 13장 검수에서 다시 확인하세요. 확인이 없으면 지시는 지켜지지 않습니다.
CHAPTER 7
의도 확인 층
숫자 게이트를 통과했는데 사람이 다른 경우가 있습니다. 두 번 크게 틀리고 나서 이 층을 만들었습니다.
첫 번째 오판 — 기기 비중
게이트를 켠 다음 날, 12개 후보 중 11개를 떨어뜨리고 살아남은 하나로 결과물을 만들었습니다. 검색 620 / 문서 4,780 / 비율 0.13. 숫자는 다 통과였습니다. 그런데 그 키워드는 어떤 협회 이름이었고, 아무도 읽지 않았습니다.
| 키워드 유형 | 모바일 비중 | 검색하는 사람 |
|---|---|---|
| 기관·협회명 | 0.27 | 업무 중 홈페이지·회원사·채용을 찾는 사람 |
| 인물명 A | 0.90 | 일반 독자 |
| 인물명 B | 0.86 | 일반 독자 |
| 인물명 C | 0.88 | 일반 독자 |
모바일이 PC보다 적은 검색어는 대개 업무용입니다. 우리 독자와 안 겹칩니다. 그래서 min_mobile 0.6이 들어갔습니다. 인물·작품·생활 검색어는 모바일이 70~90%라 안 걸립니다.
두 번째 오판 — 상위 결과의 결
더 아픈 사례입니다. 어떤 축에서 승산 1위가 비율 2.36으로 나왔습니다. 검색 35,960, 문서 15,216. 훌륭한 숫자입니다. 그런데 그 키워드로 상위 10건을 실제로 열어봤습니다.
| 글의 성격 | 건수 |
|---|---|
| 뷔페·디저트·식당 | 4 |
| 돌잔치·상견례 등 행사 | 3 |
| 근처 맛집 | 1 |
| 우리가 쓰려던 주제 | 2 |
비교 대상이던 다른 키워드는 10건 중 9건이 우리 주제였습니다. 그쪽이 맞는 자리였습니다.
지표는 다 통과했는데 사람이 달랐습니다. 첫 번째 오판과 같은 구조입니다. 그래서 층을 하나 더 얹었습니다.
daily/intent.py 를 만들어 줘. 숫자로는 통과했는데 검색하는 사람이
우리 독자가 아닌 경우를 걸러내는 층이야.

- 그 키워드로 상위 10건의 제목을 가져와서, 우리 주제 어휘가 몇 개나
  들어 있는지 센다
- 6건 이상일 때만 통과 (이 숫자도 tuning.json 에서 읽어 줘)
- 축마다 어휘 목록이 다르니 딕셔너리로 관리하게
- 상위 제목을 못 읽으면 막지 말고 통과시키고 로그만 남겨

왜 필요한지 알려줄게. 우리는 비율 2.36 으로 1위였던 키워드로 글을 썼는데,
나중에 상위 10건을 열어보니 8건이 전혀 다른 주제였어.
지표는 다 통과했는데 사람이 달랐던 거야.
daily/pick.py 를 만들어 줘. 후보 파일을 읽어 통과분만 남기는 단계야.

- candidates.json 을 읽어서 각 후보에 대해 게이트 → 의도 확인 순서로 판정
- 통과한 것만 picked.json 에 저장하고, 비율이 높은 순으로 정렬
- 몇 개가 어느 단계에서 떨어졌는지 로그에 남겨 줘
- 전부 탈락하면 종료코드 5 로 끝내 줘.
  이건 실패가 아니라 "오늘 이 축은 쓸 소재가 없다" 는 정상 상태야.
  절대로 억지로 채우지 마. 못 이길 소재로 만든 글은 순위를 못 받고
  발행 이력만 채워.
이건 특정 주제의 요령이 아니라 재사용되는 패턴입니다. 정량 지표가 통과시킨 후보를 정성 신호로 한 번 더 거르는 것. 어휘 목록은 축마다 다르지만 구조는 같고, 다른 축에 그대로 이식됩니다.
핵심은 상위 결과를 실제로 읽는다는 것입니다. 지표만 보면 절대 안 보이는 게 여기서 보입니다.
합쳐서 부르기
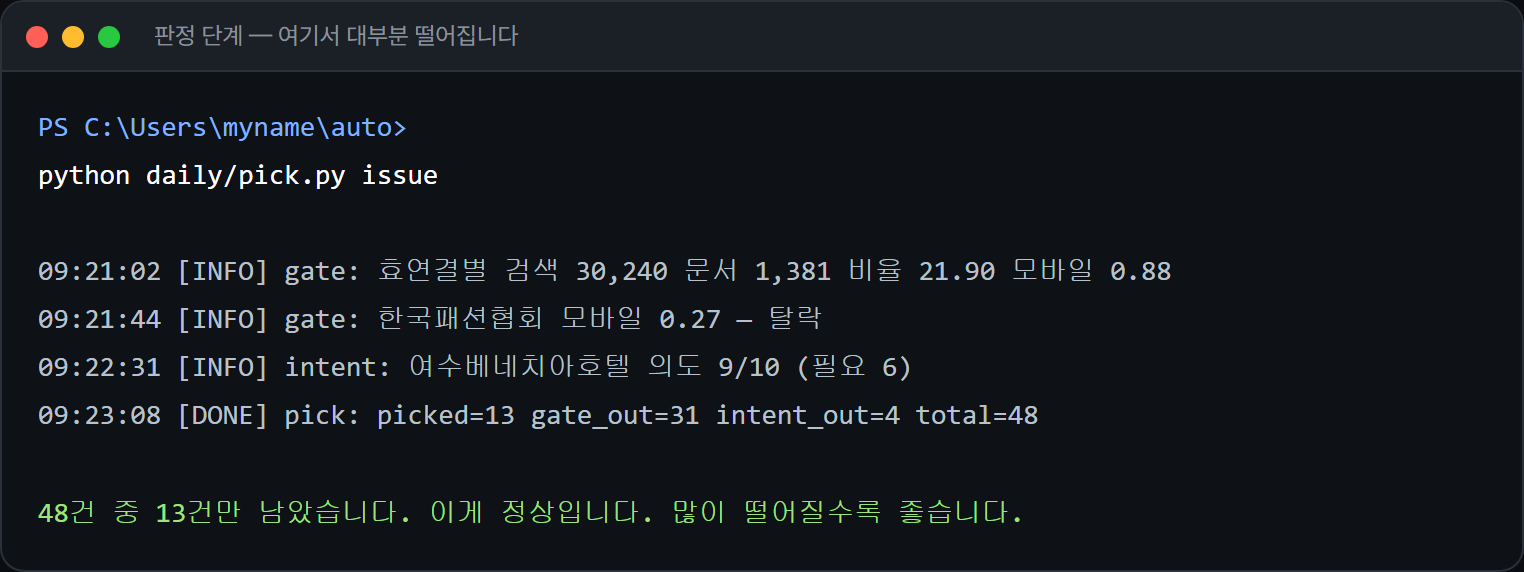
파이프라인이 매일 정해진 개수를 채우게 만들면, 못 이길 소재로도 결과물을 만듭니다. 그건 순위를 못 받고 이력만 채웁니다. 빈 축이 의미 없는 결과물보다 낫습니다. 지시문이 종료코드 5를 쓰게 한 이유입니다 — 실패가 아니라 "오늘 이 축은 없음"이라는 정상 상태입니다.
CHAPTER 8
축을 설계한다
축은 주제 분류가 아니라 판정 기준의 묶음입니다. 기준이 같으면 한 축이고, 다르면 다른 축입니다.
축을 가르는 질문 넷
- 이 축의 목적이 트래픽인가 수익인가. 조회 1건의 값이 다르므로 검색량 하한과 비율 하한이 달라집니다.
- 소재의 단위가 무엇인가. 사건 하나인지, 상품 하나인지, 장소 하나인지. 이게 앵커 추출 방식을 정합니다.
- 독자가 어디서 오는가. 검색인지 추천 피드인지. 이게 11장의 제목 규칙을 정반대로 만듭니다.
- 의도 어휘가 고정되는가. 고정되면 7장의 확인 층을 걸 수 있고, 아니면 기기 비중으로만 봅니다.
실제 세 축의 설계
| 항목 | 트래픽 축 | 상품 축 | 장소 축 |
|---|---|---|---|
| 목적 | 유입 | 수익 | 수익 |
| 소재 단위 | 사건 하나 | 상품 하나 | 장소 하나 |
| 앵커 | 인물·작품명 | 제품군+규격 / 저인지 브랜드 | 고유명 |
| 검색량 하한 | 500 | 300 | 500 |
| 문서수 상한 | 20,000 | 60,000 | 20,000 |
| 비율 하한 | 0.10 | 0.30 | 0.10 |
| 의도 확인 | 기기 비중만 | 어휘 6/10 | 어휘 6/10 |
| 제목 형태 | 궁금증으로 닫기 | 키워드 앞세우기 | 고유명 + 조건어 나열 |
| 주 노출 경로 | 추천 피드 + 검색 | 검색 | 검색 |
상품 축이 처음에 죽은 이유
상품 축은 제휴 상품을 커미션이 높은 순으로 골랐습니다. 합리적으로 보이죠. 그런데 커미션이 높은 상품은 대개 대형 제품이고, 그 대표 키워드는 구조적으로 못 이기는 급이었습니다.
| 커미션순으로 고른 상품의 키워드 | 월검색 | 문서수 | 비율 |
|---|---|---|---|
| 대형가전 A + 추천 | 16,270 | 646,809 | 0.025 |
| 대형가전 B + 추천 | 1,620 | 456,908 | 0.004 |
| 소형가전 C + 가격 | 20 | 7,236 | 0.003 |
큰 키워드는 문서가 수십만 건이고, 피해서 내려간 롱테일은 검색량이 최소 표시값입니다. 양쪽 다 못 씁니다. 그런데 상품 풀 전체를 훑으니 중간 지대가 실제로 있었습니다.
| 키워드 | 월검색 | 문서수 | 비율 | 패턴 |
|---|---|---|---|---|
| 저인지 브랜드 + 제품군 | 1,380 | 101 | 13.66 | 아무도 안 썼다 |
| 제품군 + 용량 | 21,020 | 8,651 | 2.43 | 구매 직전 검색어 |
| 저인지 브랜드 + 제품군 | 7,390 | 3,282 | 2.25 | 아무도 안 썼다 |
| 제품군 + 용량 | 15,640 | 9,531 | 1.64 | 구매 직전 검색어 |
추천·가격·순위·비교접미어는 후보 생성 단계에서 아예 제외합니다. 이 넷이 붙는 순간 문서가 수십만 건이 됩니다.- 대신 상품명에서 규격 토큰(리터·인치·와트·킬로)을 뽑아
제품군+규격을 만듭니다. - 브랜드명이 짧고 검색량이 있는데 문서가 적으면
브랜드+제품군을 만듭니다.
선정 순서를 뒤집는다
상품 축의 선정 우선순위는 승산 → 시즌 → 커미션입니다. 시즌과 커미션은 순위가 난 다음에 의미가 생기는 값이거든요. 순위가 없으면 팔리지도 남지도 않습니다.
그리고 손해도 아니었습니다. 승산 기준으로 고른 상품이 커미션 상위권이기도 했습니다. 두 기준이 꼭 충돌하지는 않습니다.
장소 축 — 헤드는 전량 버린다
세 번째 축을 만들 때 헤드 키워드 23개를 재서 전량 탈락시켰습니다.
| 키워드 유형 | 월검색 | 문서수 | 비율 | 판정 |
|---|---|---|---|---|
| 지역 + 숙박형태 | 71,800 | 158,550 | 0.453 | 탈락 |
| 카테고리 + 추천 | 54,810 | 225,784 | 0.243 | 탈락 |
| 조건 + 시설 | 3,030 | 2,326,673 | 0.001 | 탈락 |
| 고유명 A | 34,250 | 13,296 | 2.576 | 채택 |
| 고유명 B | 35,960 | 15,216 | 2.363 | 의도 탈락 |
왜 고유명이 이기나. 헤드 키워드는 10년치 재고와 싸우는데, 고유명은 그 대상이 바뀔 때마다 문서가 갱신되고 옛 글이 죽습니다. 그리고 검색 의도가 다릅니다. 카테고리 검색은 탐색 단계고, 고유명 검색은 결정 직전입니다. 수익 축에서 이 차이가 전환을 가릅니다.
지역이나 카테고리 이름 하나를 시드로 넣으면 연관 키워드가 1,000개 넘게 나옵니다. 상위 20개는 전부 헤드라 쓸모없지만, 그 아래에 고유명이 섞여 있습니다.
시드 → 연관 대량 수확 → 고유명 필터 → 문서수 비율 판정. 이 네 단계로 소재 큐가 자동 생성됩니다. 사람이 대상을 고르지 않습니다.
기존 강자와 정면으로 붙지 않는 법
장소 축의 상위 글은 예외 없이 실제 방문 후기였습니다. 우리는 안 가봤고, 가본 척은 하지 않습니다. 그럼 무엇으로 이기나.
후기에는 구조적인 빈틈이 있습니다. 후기는 자기가 겪은 한 가지만 씁니다. 특정 등급에 묵은 사람은 다른 등급을 모르고, 여름에 간 사람은 겨울 조건을 모릅니다. 그런데 독자가 결정 직전에 궁금한 건 "이 사람 경험이 어땠나"가 아니라 "내 조건에서는 뭐가 다른가"입니다.
그래서 포맷을 후기가 아니라 결정 전 확인표로 잡습니다. 등급별 차이, 조건별 가격, 운영 시간, 취소 규정처럼 후기에 잘 안 나오는 항목을 한 화면에 모읍니다. 이건 직접 겪지 않고도 정확히 쓸 수 있고, 오히려 후기보다 정확합니다 — 후기는 그날 그 조건 기준이라 시간이 지나면 틀리거든요.
이 발상은 어느 축에나 적용됩니다. 기존 상위 글이 잘하는 것을 더 잘하려 하지 말고, 그 형식이 구조적으로 못 담는 것을 찾으세요. 그 자리는 비어 있고, 우리 조건에서도 채울 수 있습니다.
어떻게 만들지 정한다
"잘 만들게 한다"는 자동화의 언어가 아닙니다. 자동화에서는 규격이라고 말해야 합니다.
CHAPTER 9
벤치마크를 잰다
규격은 상상해서 정하지 않습니다. 이미 잘 되는 곳을 골라서 재세요. 그 결과가 우리 결과물을 통째로 바꿨습니다.
무엇을 재나
눈으로 보고 "깔끔하다"고 적으면 그건 규격이 아닙니다. 기계가 확인할 수 있는 수치여야 합니다.
| 항목 | 재는 법 | 왜 중요한가 |
|---|---|---|
| 한 줄 길이 | 줄바꿈 기준 글자수 분포 | 모바일 가독성. 여기가 제일 크게 달랐다 |
| 블록 크기 | 빈 줄로 끊긴 덩어리의 줄 수 | 스크롤 피로 |
| 블록 개수 | 덩어리 총 개수 | 전체 분량 감각 |
| 본문 길이 | 공백 제외 글자수 | 길수록 좋다는 통념이 틀린 지점 |
| 이미지 수·위치 | 총 개수, 블록 대비 분포 | 뭉치면 이탈한다 |
| 정렬 비율 | 가운데 정렬 문단 / 전체 | 한눈에 다르게 보이는 항목 |
| 소제목 형태 | 숫자 포함 여부, 글자수 | 통념과 실측이 달랐다 |
| 강조 사용량 | 색·형광 적용 구간 수 | 과하면 싸구려로 보인다 |
| 항목 | 우리(개조 전) | 벤치마크 40건 실측 |
|---|---|---|
| 문단 정렬 | 왼쪽 100% | 가운데 94% |
| 한 줄 길이 | 45~77자 | 평균 18.9자 |
| 텍스트 블록 | 통짜 문단 10개 | 3~4줄 블록 20.6개 |
| 이미지 | 8장 | 19.6장 |
| 본문 길이 | 1,800~2,200자 | 평균 1,114자 |
| 소제목에 숫자 | 있음 | 0% |
본문이 짧은 쪽이 이기고 있었습니다. 우리는 길게 쓰는 게 성의라고 생각하고 있었어요. 재보지 않았으면 몰랐을 겁니다.
재는 코드
규격을 정할 때는 중앙값과 10·90 분위수를 같이 봐야 합니다. 벤치마크 40건 중 한 건이 유난히 길면 평균이 끌려갑니다. 규격의 상·하한은 분위수로 잡고, 목표값은 중앙값으로 잡으세요.
재고 나면 반드시 다시 잰다
규격을 바꾼 뒤 같은 잣대로 우리 결과물을 다시 재서 목표 범위에 들어왔는지 확인합니다. 이 확인이 없으면 규격을 바꿨다고 믿는 상태와 실제로 바뀐 상태가 갈립니다.
우리는 문단 정렬을 전부 가운데로 바꿔놓고 "정렬 개조 완료"로 기록했습니다. 나중에 다시 재보니 본문은 100% 가운데인데 이미지는 0/14였습니다. 이미지 컴포넌트에는 정렬 속성이 아예 없었거든요(14장). 항목별로 따로 재지 않으면 이런 게 안 보입니다.
재미있는 건, 다른 축은 우연히 10/10이 맞았다는 것입니다. 실력이 아니라 그 축 이미지가 전부 정사각이라 폭을 꽉 채웠기 때문이었습니다. 우연히 맞은 것과 맞게 만든 것은 다릅니다.
CHAPTER 10
규격 단일 소스
같은 숫자가 프롬프트에도 있고 조립 코드에도 있고 검수에도 있으면, 한 곳만 고치는 날이 반드시 옵니다.
결과물의 모양을 정하는 규격 파일과 그걸 읽는 기능을 만들어 줘.

[spec/style_spec.json] 아래 항목을 담아 줘
- 한 줄 글자수 (최소 15, 최대 22, 목표 19)
- 블록당 줄 수 (3~4), 블록 개수 (18~26)
- 본문 전체 글자수 (800~1500)
- 이미지 개수 (목표 14, 최소 10)
- 문단 정렬 (가운데), 폰트 이름
- 소제목 (10자 이내, 숫자 금지)
- 강조 (색 1~3곳, 형광 1~3곳)
- 제목 (30~50자, 따옴표 금지, 키워드는 앞 15자 안에)
- 축별로 다른 값만 덮어쓰는 칸 (예: 검색 위주 축은 제목 24~39자)

[daily/spec.py]
- 이 파일을 읽고, 축 이름을 주면 덮어쓰기까지 적용해 돌려주는 기능

이 파일 하나만 진실이어야 해. 프롬프트도 조립도 검수도 전부 여기서 읽어.
같은 숫자가 여러 곳에 있으면 한 곳만 고치는 날이 반드시 오고,
그러면 검수는 통과하는데 옛 규격으로 만드는 상태가 돼.
프롬프트·조립·검수 셋이 전부 이 파일을 읽습니다. 축별로 다른 항목만 axis_override에 둡니다.
프롬프트에 규격을 넣을 때 사람이 손으로 옮겨 적으면 그 순간 단일 소스가 깨집니다. 규격 객체를 프롬프트 문장으로 변환하는 함수를 하나 만들어 두면, 규격이 바뀔 때 프롬프트가 자동으로 따라갑니다. 12장에서 씁니다.
규격은 학습이 바꾼다
이 파일은 사람만 고치는 게 아닙니다. 23장의 학습 층이 성과를 보고 여기 값을 조정합니다. 그래서 코드 상수로 두면 안 됩니다. 그리고 조정 이력을 남겨야 되돌릴 수 있습니다.
CHAPTER 11
제목 규칙
제목 규칙은 취향이 아닙니다. 어디에 노출되느냐가 형태를 정합니다.
노출 경로가 둘이면 규칙도 둘이다
| 항목 | 추천 피드에서 먹는 축 | 검색에서 먹는 축 |
|---|---|---|
| 독자 상태 | 목적 없이 훑는 중 | 답을 찾는 중 |
| 이기는 형태 | 궁금증으로 닫기 | 질문어를 그대로 담기 |
| 말줄임표 | 문장 중간에, 비중 72% | 쓰지 않는다 |
| 앞머리 | 사건 먼저, 이름 뒤 | 고유명·키워드 먼저 |
| 길이 | 30~50자 | 24~39자 |
| 구성 | 훅 + 반전 | 고유명 + 조건어 3~5개 |
같은 규칙을 두 축에 쓰면 한쪽이 반드시 손해를 봅니다. 검색으로 오는 사람에게 궁금증을 남기면 안 됩니다 — 자기 질문어가 제목에 그대로 있는 결과를 누르거든요.
상위 글 제목 실측 결과 길이는 24·29·33자였고, 전부 고유명으로 시작해 조건어를 나열하는 형태였습니다. 훅이나 반전은 하나도 없었습니다. 추천 피드 축에서 잘 먹던 형태를 그대로 가져갔다면 전부 졌을 겁니다.
규칙을 기계가 확인할 수 있게 쓴다
daily/title_rules.py 를 만들어 줘. 제목 규칙을 문서가 아니라 함수로 두는 거야.

- 규격 파일에서 길이·따옴표 허용 여부를 읽어 검사
- 승산 키워드가 제목 앞 15자 안에 실제로 들어 있는지 확인
  (이게 없으면 애써 고른 키워드를 모델이 빼버려)
- 축에 따라 형태를 다르게 검사해 줘
  · 추천 피드에서 노출되는 축: 말줄임표로 궁금증을 남겨야 함
  · 검색에서 노출되는 축: 말줄임표 금지, 키워드를 그대로 담아야 함
- 위반 항목을 목록으로 돌려주게 (통과면 빈 목록)

규칙을 문서에만 적어두면 지켜지는 날과 안 지켜지는 날이 생기고,
안 지켜졌다는 걸 아무도 몰라. 그래서 함수여야 해.
제목 규칙을 마크다운 문서에 적어두고 프롬프트에 붙이면, 지켜지는 날과 안 지켜지는 날이 생깁니다. 그리고 안 지켜졌다는 걸 아무도 모릅니다. 규칙은 반드시 검수 함수로 존재해야 합니다. 문서는 그 함수의 설명일 뿐입니다.
CHAPTER 12
생성 프롬프트
모델에게 시키는 층입니다. 실패해서 배운 네 가지를 전합니다.
하나 — 구조화 출력을 JSON으로 받지 마세요
본문에 큰따옴표가 들어가는 순간 JSON이 깨집니다. 인용을 많이 쓰는 결과물일수록 파싱 실패가 잦아져요. 구분자 방식이 훨씬 안 깨집니다.
아래 형식으로만 답한다. 다른 말은 붙이지 않는다.

TITLE: (여기에 제목)
CATEGORY: (아래 목록 중 하나)
KEYWORD: (지정된 키워드를 그대로)
---
BODY:
(본문. 한 줄은 15~22자. 3~4줄마다 빈 줄로 블록을 끊는다.
 소제목은 [[ ]] 로 감싼다. 강조는 **색** 과 ==형광== 으로 표시한다.)
본문을 만드는 단계를 만들어 줘. 파일 세 개로 나눠 줘.

[daily/prompt.py]
- 규격 파일을 읽어서 지시문 문장으로 바꾸는 함수를 꼭 만들어 줘.
  사람이 규격을 손으로 옮겨 적으면 그 순간 단일 소스가 깨져
- 참고 문서에서 글쓰기와 무관한 절을 잘라내는 기능
- 전체 프롬프트가 18,000자를 넘지 않게 자르기 (넘으면 응답이 끊겨)
- 원문 범위 밖의 사실을 만들지 말라는 지시를 반드시 넣어 줘

[daily/parse.py]
- 결과를 JSON 이 아니라 구분자 형식으로 받아서 파싱해 줘.
  본문에 큰따옴표가 들어가면 JSON 이 깨져서 파싱 실패가 잦아
- 형식: TITLE: / CATEGORY: / KEYWORD: / --- / BODY:
- 형식이 깨지면 예외를 던지고, 원문을 파일로 남겨 줘.
  재시도만 하고 버리면 왜 깨졌는지 영영 몰라

[daily/extract.py]
- 원문에서 본문만 뽑는 기능
- 추출에 실패하면 예외를 던져. 절대로 HTML 전체를 대신 쓰지 마.
  그러면 메뉴랑 광고가 본문 행세를 해서 사실이 하나도 없는 글이 나가
- 저작권 문구 같은 꼬리 문장 이후는 잘라내 줘
형식이 깨지면 한 번 더 부르되, 깨진 원문을 파일로 남기세요. 재시도만 하고 버리면 왜 깨졌는지 영영 모릅니다. 같은 형태의 실패가 반복되면 그건 프롬프트를 고쳐야 한다는 신호입니다.
둘 — 프롬프트에는 크기 상한이 있습니다
참고 문서 원문을 통째로 넣었다가 계속 타임아웃을 맞았습니다. 글쓰기와 무관한 절을 잘라내 크기를 줄이니 응답이 정상으로 돌아왔습니다. 넣을 수 있는 만큼 넣지 말고, 필요한 만큼만 넣으세요.
셋 — 원문 추출에 폴백을 두지 마세요
원문에서 본문만 뽑을 때 추출에 실패하면 HTML 전체를 넘기도록 폴백을 두기 쉽습니다. 그러면 메뉴·광고·추천 목록이 본문 행세를 하고, 모델은 그걸로 그럴듯한 글을 씁니다. 사실이 하나도 없는 결과물이 매일 나갑니다. 추출에 실패하면 그 소재를 버리세요.
넷 — 사실 범위를 프롬프트로 묶는다
원문에 없는 사실을 쓰지 말라는 지시는 반드시 넣습니다. 그리고 그게 지켜지는지 확인할 방법도 하나 둡니다 — 완벽하지는 않지만, 숫자와 고유명이 원문에 있는지 대조하는 것만으로도 큰 사고를 막습니다.
CHAPTER 13
기계 검수
사람이 눈으로 보는 검수는 무인 파이프라인에 존재하지 않는 층입니다.
규격을 정했으면 그걸 기계로 확인해야 의미가 있습니다. 그리고 검수는 생성 다음이 아니라 출고 앞에 둡니다. 조립 과정에서 규격이 깨지는 경우가 실제로 있기 때문입니다.
daily/qa_gate.py 를 만들어 줘. 규격 위반을 기계가 잡는 단계야.
사람 눈으로 하는 검수는 무인 자동화에 존재하지 않는 층이라 이게 필요해.

- 규격 파일을 읽어서 본문 길이, 줄 길이, 블록 수, 소제목, 강조 개수,
  이미지 개수, 제목 규칙을 전부 검사
- 위반을 하나도 안 빠뜨리고 목록으로 돌려줘 (첫 위반에서 멈추지 말고)
- 위반이 있으면 종료코드 2 로 끝내 줘
- 가짜 입력으로 판정 로직만 돌려보는 자체 시험 기능도 같이 만들어 줘.
  실제 결과물이 없어도 검수가 멀쩡한지 확인할 수 있어야 해.
  규격이 바뀔 때 검수가 같이 안 바뀌면 검수가 조용히 무장해제되거든
- 위반 종류별 횟수를 파일에 쌓아 줘. 같은 위반이 매일 나오면
  그건 모델 실수가 아니라 지시문을 고쳐야 한다는 신호야
자체 시험
검수 코드에는 반드시 자체 시험을 붙이세요. 규격이 바뀔 때 검수가 같이 안 바뀌면 검수가 조용히 무장해제됩니다.
대부분 산출물만 검증하고 판단하는 코드 자체는 검증하지 않습니다. 그런데 검수가 망가지면 잘못된 결과물이 전부 통과합니다. 가짜 입력으로 판정만 돌려보는 시험을 매일 한 번 돌리세요. 실제 결과물을 만들지 않아도 됩니다.
검수에서 걸리면 무엇을 하나
- 재생성 1회. 위반 목록을 프롬프트에 붙여서 다시 시킵니다. 대부분 여기서 해결됩니다.
- 그래도 걸리면 그 소재를 버립니다. 무한 재시도는 비용만 씁니다.
- 같은 위반이 반복되면 규격이나 프롬프트를 고칩니다. 위반 종류별 집계를 남겨두면 이게 보입니다.
{"date":"2026-08-06","axis":"issue","violation":"긴 줄","count":3}
{"date":"2026-08-06","axis":"issue","violation":"소제목에 숫자","count":1}
{"date":"2026-08-07","axis":"issue","violation":"긴 줄","count":4}

→ '긴 줄' 이 매일 나오면 그건 모델의 실수가 아니라
   프롬프트에서 줄 길이 지시가 약하다는 뜻이다.
CHAPTER 12.5
모델을 부르는 층 — 새벽에 누가 글을 쓰나
앞 장에서 프롬프트를 만들었습니다. 그런데 그걸 누가 모델에 보내나가 남았습니다. 사람이 없는 새벽 네 시에요.
세 가지 방식
| 방식 | 어떻게 | 비용 | 무인 실행 |
|---|---|---|---|
| 구독 CLI | 설치한 코딩 에이전트를 명령으로 부른다 | 구독 안 | 됩니다 |
| API 종량 | 키를 발급받아 직접 호출 | 쓴 만큼 | 가장 안정적 |
| 대화창 수동 | 사람이 복사해서 붙여넣음 | 구독 안 | 안 됩니다 |
시작은 구독 CLI로 하세요. 이미 설치했고 추가 비용이 없습니다. 안정적으로 굴리게 되면 API로 옮기면 됩니다.
구독 CLI를 명령으로 부르는 법
두 도구 다 대화창 없이 한 번만 실행하는 모드가 있습니다.
claude -p "여기에 프롬프트"
type prompt.txt | claude -p "위 내용대로 써줘"     (윈도우)
cat prompt.txt | claude -p "위 내용대로 써줘"      (맥·리눅스)
codex exec "여기에 프롬프트"
프롬프트가 길면 명령줄에 그대로 넣지 마세요. 따옴표와 줄바꿈이 깨지고, 운영체제마다 명령줄 길이 제한도 다릅니다. 파일에 쓴 다음 파이프로 흘려보내는 방식이 안전합니다. 우리 프롬프트는 1만 자가 넘습니다.
CLI 도구는 진행 상황을 화면에 찍습니다. 그걸 결과와 같이 받아버리면 파싱이 깨집니다. 표준 출력과 오류 출력을 나눠서 받고, 결과는 표준 출력만 쓰세요. 도구에 따라 구조화된 형식으로 받는 옵션이 있으면 그쪽이 더 안전합니다.
구독 CLI는 로그인 상태로 동작합니다. 그 상태가 만료되면 스케줄러가 부른 실행이 조용히 실패합니다. 화면이 없으니 로그인 창을 띄울 수도 없어요.
19장의 가드가 이걸 잡아야 합니다. 생성 단계의 증거 파일이 며칠 비어 있으면 인증을 의심하세요. 그리고 CLI가 인증 실패를 표준 출력에 결과처럼 찍는 경우가 있어서, 응답에 우리 형식(TITLE:/BODY:)이 없으면 실패로 처리해야 합니다.
모델 호출이 응답하지 않으면 그 프로세스가 계속 살아 있습니다. 다음 날 배치는 잠금에 막혀 안 돌고, 아무도 모릅니다. 반드시 시간 제한을 두고, 넘으면 죽이고 실패로 기록하세요.
daily/llm.py 를 만들어 줘. 프롬프트를 모델에 보내고 답을 받는 층이야.
이 층만 갈아끼우면 나중에 다른 모델로 바꿀 수 있게 만들어 줘.

[동작]
- ask(prompt: str) -> str  함수 하나가 핵심이다
- 어떤 방식으로 부를지는 .env 의 LLM_MODE 로 고른다
    cli   : 설치된 코딩 에이전트를 명령으로 부른다 (기본값)
    api   : API 키로 직접 부른다
- cli 모드일 때 부를 명령도 .env 에서 읽게 해줘 (LLM_CMD)
    예) claude -p          또는       codex exec

[cli 모드에서 지킬 것]
- 프롬프트를 명령줄 인자로 넣지 마라. 임시 파일에 쓰고 표준 입력으로 흘려보내라.
  우리 프롬프트는 1만 자가 넘어서 명령줄에 못 넣는다
- 표준 출력과 오류 출력을 나눠서 받아라. 결과는 표준 출력만 쓴다
- 시간 제한을 반드시 걸어라 (기본 300초). 넘으면 프로세스를 죽이고 실패로 처리
- 인코딩을 UTF-8 로 고정해라. 윈도우에서 한글이 깨진다
- 종료코드가 0 이 아니면 실패다. 다만 출력이 있으면 로그에 남겨라

[응답 검증 — 중요]
- 받은 답에 우리 형식(TITLE: 과 BODY:)이 없으면 실패로 처리해라.
  인증이 풀렸을 때 안내 문구가 결과처럼 오는 경우가 있는데,
  그걸 글로 착각하면 이상한 게 발행된다
- 실패한 응답은 통째로 work/ 에 파일로 남겨라. 왜 실패했는지 봐야 한다

[재시도]
- 형식이 깨지면 한 번만 다시 부른다. 두 번째도 깨지면 그 소재를 버린다
- 무한 재시도는 절대 만들지 마라. 사용량만 쓴다

[api 모드]
- 지금은 뼈대만 만들어 두고, 실제 호출은 주석으로 자리만 잡아줘.
  나중에 옮길 때 이 파일만 고치면 되게

마지막에
- .env 에 추가할 항목
- 이 파일만 따로 시험해 보는 방법 (짧은 프롬프트로 한 번 불러보기)
- 성공했을 때와 인증이 풀렸을 때 각각 어떻게 보이는지
비용 감각
구독으로 쓰면 추가 비용이 없습니다. 다만 하루 두 편이면 하루 두 번 호출이고, 이건 시간 창 한도에 거의 영향이 없습니다. 사람이 대화하는 것보다 훨씬 적게 씁니다.
API 종량으로 옮기면 편당 비용이 생깁니다. 계산은 이렇게 잡으세요. 우리 프롬프트가 약 1만 5천 자, 응답이 약 1천 5백 자입니다. 요금은 글자가 아니라 토큰 기준이고 모델마다 다르므로, 쓰려는 모델의 공식 요금 페이지에서 입력·출력 단가를 확인한 뒤 이 분량으로 곱하세요. 하루 두 편이면 그 값의 두 배가 하루치입니다.
셋 중 하나에 해당하면 옮기세요. 구독 한도에 자주 걸린다, 여러 축을 굴려서 하루 호출이 열 번을 넘는다, 인증 만료로 배치가 멈춘 적이 있다. 그 전까지는 구독 CLI가 더 쌉니다.
CHAPTER 12.6
이미지 — 어디서 구하고 무엇을 만드나
글만 있으면 안 읽힙니다. 규격이 이미지 열 장 이상인데, 그걸 매일 어디서 구하나요.
세 갈래
| 출처 | 쓸 수 있는 조건 | 주의 |
|---|---|---|
| 원문에 딸린 것 | 원문을 인용하는 형태일 때 | 본문 영역 안의 것만. 추천 목록 썸네일이 섞인다 |
| 무료 이미지 | 라이선스가 상업적 사용을 허용할 때 | 맥락이 맞는지 사람이 한 번 봐야 한다 |
| 직접 만든 카드 | 언제나 | 라이선스 걱정이 없고 우리 것이 된다 |
무료 이미지 사이트에서 검색어로 자동으로 가져오면 엉뚱한 사진이 들어옵니다. 라이선스는 통과했는데 글과 아무 상관이 없어요. 실제로 영화 주제 글에 정치인 사진이, 예능 글에 스포츠 선수 사진이 들어간 적이 있습니다.
자동으로 쓸 검색어를 미리 정해두고 그 목록 안에서만 가져오세요. 아무 낱말이나 검색어로 쓰면 안 됩니다.
정보 카드 — 이게 제일 안전하고 제일 좋습니다
글의 내용을 그림으로 만든 카드입니다. 앞의 발행 캡쳐에서 보신 것이 이겁니다. 라이선스 문제가 없고, 매번 같은 모양이라 브랜드가 되고, 무엇보다 글에 있는 내용이라 맥락이 100% 맞습니다.
만드는 방식은 간단합니다. HTML로 카드를 그리고 화면을 찍어 이미지로 저장합니다. 16.5장에서 설치한 브라우저 도구를 그대로 씁니다.
daily/card.py 를 만들어 줘. 글 내용을 이미지 카드로 만드는 층이야.
브라우저 도구(playwright)를 써도 좋아. 발행 층과 같은 것을 쓴다.

[동작]
- HTML 을 만들고, 그 화면을 찍어 PNG 로 저장한다
- 크기는 정사각 886 x 886 으로 고정 (본문 폭을 꽉 채워서 정렬 문제가 안 생긴다)
- 배경은 짙은 단색, 글자는 밝은색. 폰트는 굵고 크게
- 글자가 길면 자동으로 줄바꿈하고, 너무 길면 폰트를 줄인다

[카드 종류 네 가지를 만들어 줘]
1. 표지형   : 큰 제목 한 줄 + 부제 한 줄
2. 타임라인 : 날짜와 사건 3~5개를 세로로
3. 수치형   : 큰 숫자 하나 + 설명 한 줄
4. 요약형   : 3줄 요약

[지킬 것]
- 글자만 넣으면 카드가 만들어지게 함수를 나눠 줘
- 한 글에 카드는 최대 2장까지만 (카드만 여러 장이면 티가 난다)
- 파일 이름에 배치 아이디를 넣어 나중에 어느 글의 카드인지 알게
- 폰트가 없으면 어떻게 되는지 알려주고, 한글이 깨지지 않게 폰트를 지정해 줘

마지막에
- 네 종류를 한 번씩 만들어 보는 시험 명령
- 만들어진 파일을 어디서 확인하는지
daily/images.py 를 만들어 줘. 한 글에 쓸 이미지를 모으는 층이야.

[순서 — 이 순서를 지켜라]
1. 원문에 딸린 이미지를 먼저 쓴다. 단 본문 영역 안의 것만.
   추천 목록이나 사이드바의 썸네일이 섞이면 다른 주제 사진이 들어온다
2. 모자라면 미리 정해둔 검색어 목록으로 무료 이미지를 가져온다.
   검색어는 파일 위쪽에 목록으로 두고 내가 관리한다.
   글에서 아무 낱말이나 뽑아 검색어로 쓰지 마라
3. 그래도 모자라면 card.py 로 정보 카드를 만든다 (최대 2장)

[거르기]
- 가로세로 비율이 극단적인 것은 뺀다 (세로로 아주 긴 것)
- 해상도가 너무 낮은 것도 뺀다
- 파일 크기가 0 이거나 열리지 않는 것도 뺀다

[지킬 것]
- 내려받을 때 요청 간격을 흔든다 (net.py 를 쓴다)
- 목표 장수는 규격 파일에서 읽는다
- 몇 장을 어느 출처에서 가져왔는지 로그에 남겨라.
  나중에 "카드만 많은 글" 을 찾아낼 수 있어야 한다

마지막에 시험 명령과, 결과를 어디서 확인하는지 알려줘.
이미지는 저작권이 있는 재산입니다. 무료 사이트라도 라이선스 조건을 반드시 확인하세요. 조건에 출처 표기가 있으면 표기해야 하고, 상업적 사용이 제한되면 광고나 제휴가 붙은 글에는 못 씁니다.
이게 번거로우면 정보 카드 비중을 늘리세요. 직접 만든 것에는 이 문제가 없습니다.
내보낸다
여기가 정책적으로 가장 민감한 구간입니다. 1장의 경고를 다시 읽고 오세요. 이 부에서는 우리가 실측으로 확인한 사실만 적습니다.
CHAPTER 14
조립 — 필드명이 틀리면 조용히 버려진다
이 장이 제일 아팠습니다. 에러가 안 납니다. 그냥 무시됩니다.
문서 모델이라는 개념
요즘 에디터는 대부분 화면의 HTML이 아니라 문서 모델을 진실로 둡니다. 문단·이미지·인용구가 각각 객체이고, 편집기는 그 객체 배열을 렌더할 뿐입니다. 그래서 자동화의 올바른 접근은 화면을 조작하는 게 아니라 문서 모델을 만들어 통째로 주입하는 것입니다.
우리는 이 방식으로 이틀을 보내고 전부 폐기했습니다. 겪은 사고를 그대로 적습니다.
- 문단이 안 끊겨 통짜 줄글이 됨
- 인용구 컴포넌트가 생성되지 않음
- 임시저장이 오염돼 이전 내용이 섞임
- 붙여넣기가 두 번 들어가 본문 중복
- 캐럿이 튀어 본문 일부 누락
- 창 포커스가 바뀌어 다른 창에 타이핑
전부 그 방식의 구조적 결함이지 실수가 아닙니다. 화면 위치는 언제든 바뀌고, 사람이 컴퓨터를 만지면 포커스가 옮겨갑니다.
실측으로 확정한 스키마
필드명은 추측하지 말고 실제로 넣어보고 남는지 확인해야 합니다. 우리가 확인한 것들입니다.
문단 정렬 : paragraph.style = { '@ctype':'paragraphStyle', align:'center' }
            ⚠️ paragraph.align 처럼 평평하게 주면 버려진다

글자색    : nodeStyle.fontColor            ⚠️ 'color' 는 버려진다
형광      : nodeStyle.backgroundColor      ⚠️ 'bgColor' 는 버려진다
폰트      : nodeStyle.fontFamily           ⚠️ 'fontFamilyCode' 는 버려진다
            지정하지 않으면 기본 폰트가 나간다

인용구    : { layout:'quotation_line', value:[...], source:null,
              '@ctype':'quotation' }
구분선    : { layout:'line1', '@ctype':'horizontalLine' }

이미지 캡션 : image.caption 은 객체가 아니라 **문단 배열 그 자체**다
              [ { id, nodes:[textNode], '@ctype':'paragraph' } ]
              { id, value:[...], '@ctype':'caption' } 로 주면 주입이 죽는다
손으로 한 번 만들어 저장한 뒤, 그 문서 모델을 그대로 꺼내 읽으세요. 그게 정답지입니다. 문서를 뒤지는 것보다 빠르고 정확합니다.
그리고 후보 필드를 실제로 주입해 보고 남는지를 확인하는 작은 스크립트를 하나 만들어 두면, 에디터가 업데이트될 때 계약이 깨졌는지 바로 압니다.
본문 정렬을 다 고쳐놓고 "정렬은 끝났다"고 기록했는데, 재보니 본문은 100% 가운데인데 이미지는 0/14였습니다. 에디터가 만든 이미지 객체에는 정렬 속성이 처음부터 없습니다. 없으면 안 되는 게 아니라 주입하면 남습니다. 조립할 때 이미지마다 넣어주세요.
조립기
daily/assemble.py 를 만들어 줘. 초안을 최종 형태로 붙이는 단계야.

- 강조 표시(**색**, ==형광==)와 소제목([[ ]])을 각각의 요소로 바꾸기
- 이미지를 블록 사이에 균등하게 배분 (끝에 몰리면 안 읽혀)
- 모든 문단에 정렬과 폰트를 강제로 넣기.
  지정하지 않으면 기본값이 나가버려
- 이미지에도 가운데 정렬 속성을 넣어 줘.
  원래 없는 속성인데 넣으면 남아. 이걸 안 해서 본문은 다 가운데인데
  이미지만 14장 전부 제각각이었던 적이 있어

이미지를 고를 때 지켜야 할 것도 같이 반영해 줘.
- 원문 본문 영역 안의 이미지만 쓰기 (추천 목록 썸네일이 섞이면 안 돼)
- 보충할 때는 이미지 설명 텍스트가 주제와 맞는지 확인.
  제목 낱말만 보면 엉뚱한 사진이 들어가
- 세로로 극단적으로 길거나 해상도가 낮은 이미지는 제외
이미지 확보
이미지 파이프라인은 순서가 중요합니다. 아무 이미지나 넣으면 맥락이 어긋난 결과물이 나갑니다.
- 원문에 딸린 이미지를 먼저 씁니다. 단 본문 영역 안의 것만 — 추천 목록의 썸네일이 섞이면 다른 주제 이미지가 들어옵니다.
- 보충이 필요하면 관련 문서에서 가져오되, 이미지의 설명 텍스트가 주제와 맞는지 확인합니다. 제목 낱말만으로 판정하면 엉뚱한 게 들어옵니다.
- 그래도 모자라면 생성 이미지를 씁니다. 다만 상한을 두세요. 생성 이미지만 여러 장인 결과물은 티가 납니다.
관련 문서에서 이미지를 보충할 때 제목 낱말 일치만 보면 사고가 납니다. 실제로 영화 주제 글에 정치인 사진이, 예능 주제 글에 스포츠 선수 사진이 들어갔습니다. 이미지의 설명 텍스트(alt·캡션)가 주제와 맞는지를 같이 봐야 합니다.
세로로 아주 긴 이미지나 저해상도 이미지가 섞이면 그 자리에서 읽는 흐름이 끊깁니다. 폭·높이 비율과 최소 해상도로 걸러내세요. 코드 한 줄인데 결과물 품질에 크게 영향을 줍니다.
CHAPTER 15
발행과 성공 판정
성공 판정을 어떻게 하느냐가 이 층 전체의 신뢰도를 정합니다.
일어난 일
발행이 2단계인 경우가 많습니다. 툴바 버튼을 누르면 레이어가 뜨고, 그 안의 버튼을 또 눌러야 실제로 나갑니다. 우리는 첫 번째만 누르고 성공으로 기록했고, 6건이 임시저장 상태로 남은 채 성공으로 찍혔습니다. 장부에는 발행 6건, 실제로는 0건.
발행 후 이동한 주소의 형태로 성공을 판정하다가 두 번 틀렸습니다. 임시저장에서도 비슷한 주소가 나오는 경우가 있었고, 주소 형식이 바뀌자 전부 실패로 잡혔습니다.
결국 로그인하지 않은 상태로 그 주소를 열어 정상 응답이 오는지로만 판정하게 바꿨습니다. 내 세션으로는 임시저장도, 비공개도 보입니다. 남의 눈에 보이는 것만 발행입니다.
daily/verify.py 와 daily/preview.py 를 만들어 줘.

[verify.py] 발행 성공 판정
- 로그인하지 않은 상태로 그 주소를 열어서 정상 응답이 오는지 확인
- 쿠키를 절대 싣지 마. 내 세션으로는 임시저장도 비공개도 다 보여
- 200 이 와도 본문에 "삭제되었거나", "존재하지 않" 같은 안내 문구가 있으면
  실패로 판정 (없는 문서에도 200 을 주는 곳이 많아)

[preview.py] 발행하지 않고 확인
- 조립 결과를 읽어서 문단 수, 가운데 정렬 비율, 이미지 수와 정렬 상태,
  평균 줄 길이, 규격 초과 줄 수, 본문 길이를 숫자로 내주기
- 규격 목표 범위와 대조해서 경고를 찍어 주기

두 번째가 중요해. 규격을 바꿀 때마다 실제로 발행하면서 확인하면
내 계정이 실험장이 돼버려.
많은 서비스가 없는 문서에도 200과 함께 안내 페이지를 줍니다. 상태 코드만 보면 통과합니다. 본문 앞부분에 실패 안내 문구가 있는지까지 봐야 합니다. 지시문에서 본문 앞부분만 읽게 한 이유가 그것입니다.
발행하지 않고 확인하는 경로
규격을 바꿀 때마다 실제로 내보내면서 확인하면 계정이 실험장이 됩니다. 조립 결과를 내보내지 않고 캡처하고 수치로 재는 스크립트를 하나 두세요. 이걸 만든 뒤로 우리는 개조 검증을 한 건도 실제 발행 없이 합니다.
장부
무엇을 언제 내보냈는지 기록합니다. 그런데 이 장부를 판정에 쓰면 안 되는 경우가 있습니다. 다음 장에서 다룹니다.
2026-08-06T16:12:04+09:00	issue	https://…/12345	제목…	batch=20260806-090012
2026-08-06T18:03:41+09:00	issue	https://…/12346	제목…	batch=20260806-090012

탭 구분. 시각은 ISO + 타임존. 배치 아이디를 남겨야 나중에 추적된다.
CSV 가 아니라 TSV 인 이유: 제목에 쉼표가 들어가도 칸이 안 밀린다(21장 함정 참고).
CHAPTER 16
예약과 상한 관문
발행량은 파이프라인이 내는 신호 중 가장 큽니다. 재량에 남기면 반드시 어느 날 터집니다.
일어난 일
"하루 1건 제약을 풀라"는 지시를 상한 제거로 구현했습니다. 그날 밀려 있던 재고가 한꺼번에 나가면서 구독자가 서른 명도 안 되는 계정에 하루 13편이 발행됐습니다.
그날 밤에 나간 셋의 조회수는 0, 1, 1이었고 같은 날 낮에 나간 건 1,460이었습니다. 플랫폼에 하루 상한이 없더라도, 신생 계정의 대량 발행은 스팸 판정 로직을 건드립니다.
상한을 코드 관문으로
daily/quota.py 를 만들어 줘. 하루 발행 상한을 코드로 막는 관문이야.

- 축별로 상한을 따로 둬 줘. 총량만 두면 먼저 도는 축이 그날 몫을
  다 먹어버려서 다른 축은 영원히 0 이 돼
- 만든 날이 아니라 공개되는 날 기준으로 세 줘.
  그래야 하루에 여러 개 만들어 일주일에 나눠 예약할 수 있어
- 우리가 기록한 장부가 아니라 실제 채널 목록을 세는 함수를 부르게 해줘.
  장부는 이 프로그램을 거친 것만 알아서, 손으로 올린 건 안 보여.
  그러면 "아직 안 찼다" 가 영원히 참이 돼
- 그 함수는 지금은 비워두고, 어디를 채워야 하는지 주석으로 표시해 줘
- 상한을 넘으면 종료코드 3 으로 막아 줘

daily/schedule_slot.py 도 같이 만들어 줘. 예약 시각을 고르는 기능인데,
매일 정확히 같은 시각이면 그 자체가 기계라는 신호라서
0~14분 사이로 흔들어 줘.
"하루 5건"처럼 전체 목표만 두면, 아침에 먼저 도는 축이 재고를 다 써서 5건을 채웁니다. 다른 축은 영원히 0입니다. 실제로 한 축이 0편으로 몇 주를 보낸 적이 있습니다. 상한은 축별로 쪼개세요.
상한 판정을 우리 장부로 하면, 파이프라인 밖에서 올라간 건 안 보입니다. 그래서 실제로는 이미 다섯 개가 나갔는데 관문은 "아직 두 칸 남음"이라고 답합니다. 실물을 세세요. 조회 비용이 들더라도 이건 아껴서는 안 되는 자리입니다.
예약 시각을 정하는 법
시각도 실측으로 정합니다. 잘 되는 곳의 발행 시각 분포를 재보면 대개 몰리는 구간이 있습니다. 그리고 정확히 같은 시각에 매일 내보내지 마세요. 지터를 넣습니다.
상한을 공개 예정일 기준으로 세면, 하루에 열 개를 만들어 일주일에 흩뿌리는 게 가능해집니다. 생성 능력과 발행 속도를 분리하는 겁니다. 만든 날 기준으로 세면 이걸 못 합니다.
실제로 올리기 — 발행 층
여기가 없으면 앞의 전부가 파일로만 남습니다. 브라우저를 띄우고, 로그인을 유지하고, 에디터에 넣고, 실제로 내보내는 층입니다.
CHAPTER 16.4
블로그 준비 — 자동화 전에 사람이 해둘 것
발행 자동화는 이미 자리가 잡힌 블로그에 글을 넣는 일입니다. 그 자리를 먼저 만들어 둬야 합니다.
사람이 손으로 해둘 다섯
- 블로그를 만들고 이름을 정합니다. 주소는 나중에 바꾸기 어려우니 처음에 정하세요. 사람 이름보다 주제가 드러나는 편이 낫습니다.
- 카테고리를 축 수만큼 만듭니다. 자동화는 카테고리를 이름으로 고릅니다. 이름을 나중에 바꾸면 발행이 조용히 실패하거나 엉뚱한 곳으로 갑니다. 처음에 확정하세요.
- 카테고리마다 주제 분류를 지정합니다. 이걸 비워두면 추천 피드 진입 자체가 안 되는 경우가 있습니다. 신생 계정에는 피드가 제일 큰 유입원이라 놓치면 손해가 큽니다.
- 기본 정보를 채웁니다. 블로그 소개, 대표 주제. 광고 심사에서도 보는 항목입니다.
- 글을 몇 개 손으로 씁니다. 자동화 첫 글이 그 블로그의 첫 글이면 좋지 않습니다. 사람이 쓴 글이 먼저 몇 개 있어야 합니다.
블로그 관리 화면에서 값을 바꾸고 저장 버튼을 눌렀는데 반영이 안 되는 경우가 있습니다. 안쪽 영역의 확인과 바깥의 확인이 따로인 구조예요. 저장한 뒤 화면을 새로고침해서 값이 실제로 남았는지 확인하세요. 저장한 척하고 원복되는 게 제일 골치 아픕니다.
자동화가 카테고리를 이름으로 고르고, 통계도 그 이름으로 축을 가릅니다. 그래서 카테고리 이름은 세 곳에서 똑같아야 합니다 — 블로그 관리 화면, 규격·설정 파일, 통계 화이트리스트. 하나만 달라도 글이 조용히 다른 축으로 새거나 발행이 실패합니다.
주제를 못 정하겠다면
전략부에서 축은 골랐지만 구체적인 주제가 안 정해질 수 있습니다. 조건은 셋입니다. 오래 볼 수 있고, 소재가 매일 생기고, 내가 최소한의 판단은 할 수 있는 분야. 셋 다 못 채우면 두 달 안에 지칩니다.
블로그 주제를 정하려고 해. 내 조건은 이래.

- 내가 관심 있거나 조금이라도 아는 분야: (적어주세요)
- 하루에 쓸 수 있는 시간: (적어주세요)
- 수익 방식은 (광고 / 제휴 / 아직 모름) 을 생각하고 있어

후보를 다섯 개만 뽑아 줘. 각각에 대해
1) 소재가 매일 새로 생기는 분야인지 (아니면 금방 마른다)
2) 이미 쓴 사람이 얼마나 많을 것 같은지
3) 제휴를 붙인다면 어떤 종류가 맞는지
4) 이 주제의 약점 하나

그리고 마지막에 내 조건에서 하나를 추천하고 이유를 세 줄로.
막연한 추천 말고, 위 네 항목을 근거로.
블로그 만들기, 카테고리 정하기, 주제 고르기. 이 셋은 자동화하지 마세요. 한 번만 하는 일이고, 잘못 정하면 되돌리기가 제일 비싼 것들입니다.
CHAPTER 16.5
브라우저 자동화 준비
발행만은 표준 기능으로 안 됩니다. 여기서만 도구를 하나 더 씁니다.
지금까지 모든 지시문에 "설치가 필요한 라이브러리는 쓰지 마라"를 넣었습니다. 의존성이 하나 줄면 무인 실행에서 깨질 자리가 하나 줄기 때문입니다.
발행 층만 예외입니다. 브라우저를 프로그램으로 조종해야 하고, 그건 표준 기능으로 안 됩니다. 대신 이 층에서만 쓰고 다른 층으로 번지지 않게 합니다. 이 층이 죽어도 판정·측정·학습은 그대로 돌아야 하니까요.
플랫폼 운영정책은 대체로 자동 프로그램 사용을 금지합니다. 제재는 노출 강등부터 접근 제한까지 단계적입니다. 이 층을 만들지 않고 발행만 손으로 해도 이 책의 나머지는 그대로 유효합니다. 판단하고 오세요.
설치
pip install playwright
playwright install chromium
두 번째 줄이 브라우저 본체를 받습니다. 첫 줄만 하면 "브라우저를 못 찾겠다"는 오류가 납니다. 여기서 한 번씩 걸립니다.
전용 프로필 — 로그인을 한 번만 하는 법
자동화가 매번 새로 로그인하면 그 자체가 이상 신호입니다. 로그인 상태를 폴더 하나에 저장해두고 매번 그 폴더로 브라우저를 여는 방식이 맞습니다. 사람이 쓰는 브라우저와 똑같은 상태가 유지됩니다.
발행 층을 만들 차례야. 여기서만 playwright 를 써도 좋아.
(다른 층은 계속 표준 기능만 쓴다)

daily/browser.py 를 만들어 줘.

[핵심 요구]
- playwright 의 sync_api 를 쓰고, chromium 을 launch_persistent_context 로 연다
- 프로필 폴더는 daily/work/profile 로 고정한다.
  이 폴더에 로그인 상태가 저장돼서 다음부터는 로그인을 안 해도 된다
- headless=False 로 연다. 화면 없는 모드는 탐지 표면이 크다
- 창이 작업을 방해하지 않게 화면 밖 좌표로 옮기는 옵션을 넣어줘
  (예: --window-position=-2400,0). 최소화하면 렌더링이 멈추는 경우가 있어서
  최소화가 아니라 화면 밖으로 보내는 방식이어야 해
- 브라우저를 열고 닫는 함수를 with 문으로 쓸 수 있게 만들어 줘
- 사람이 쓰는 것처럼 보이게 기본 대기 시간을 넉넉히 두고,
  클릭과 클릭 사이에 0.4~1.2초 사이의 흔들리는 대기를 넣는 헬퍼도 만들어 줘

[최초 1회 로그인용 함수도 같이]
- login_once() : 브라우저를 열고 로그인 페이지로 이동한 다음,
  "로그인을 마치고 엔터를 누르세요" 하고 사람을 기다린다.
  엔터를 누르면 프로필에 저장되고 종료된다.
  ⚠️ 아이디·비밀번호를 코드에 넣지 마라. 사람이 직접 입력한다.

[세션 확인 함수]
- is_logged_in() : 로그인해야만 보이는 페이지를 열어 확인한다.
  로그인 페이지로 튕기면 False.

마지막에 최초 1회 로그인을 실행하는 명령과,
성공했을 때 어떤 폴더에 무엇이 생기는지 알려줘.
브라우저를 강제 종료하면 저장 중이던 쿠키가 유실됩니다. 다음 실행에서 다시 로그인해야 하고, 재로그인이 반복되면 그게 이상 신호가 됩니다. 반드시 정상 종료로 닫으세요. 지시문의 with 문 구조가 그 역할을 합니다.
같은 프로필로 브라우저 두 개를 동시에 열 수 없습니다. 배치가 겹치면 프로필이 손상돼 로그인이 통째로 날아가기도 합니다. 18장의 잠금이 여기서도 필요합니다.
CHAPTER 16.6
에디터에 넣고 내보내기
화면을 클릭해서 글을 만들지 않습니다. 문서 모델을 통째로 주입합니다.
왜 주입인가
요즘 에디터는 화면의 HTML이 아니라 문서 모델을 진실로 둡니다. 문단·이미지·인용구가 각각 객체이고, 화면은 그걸 그린 결과일 뿐입니다. 그래서 화면을 조작하면 모델과 어긋나고, 어긋나면 저장이 조용히 실패합니다.
많은 에디터가 그 모델을 읽고 쓰는 함수를 페이지 전역에 노출합니다. 그걸 쓰면 글 전체를 한 번에 넣을 수 있습니다. 14장에서 실측한 필드 이름들이 여기서 쓰입니다.
daily/publish.py 를 만들어 줘. 조립된 문서를 실제로 올리는 단계야.
앞에서 만든 daily/browser.py 를 쓴다.

[절차]
1. 브라우저를 열고 글쓰기 페이지로 이동
2. 이전에 쓰다 만 글이 있으면 복구 여부를 묻는 창이 뜬다.
   반드시 "새로 작성" 쪽을 선택해라. 이걸 놓치면 지난 내용이 섞인다
3. 편집 영역은 중첩된 프레임 안에 있는 경우가 많다.
   먼저 프레임을 잡고 그 안에서 작업해라
4. 페이지 전역에 노출된 에디터 객체를 찾아라.
   보통 getDocumentData() / setDocumentData() 같은 함수를 가진 객체다.
   찾는 방법: 페이지에서 자바스크립트를 실행해 window 의 속성 중
   그 두 함수를 모두 가진 객체를 탐색해라. 이름을 추측하지 말고 실제로 찾아라
5. 먼저 getDocumentData() 로 현재 구조를 읽어서 형식을 파악해라
6. 우리가 조립한 문서를 그 형식에 맞춰 setDocumentData() 로 통째로 주입해라
7. 제목도 같은 방식으로 넣어라

[주입할 때 지킬 것 — 틀리면 에러 없이 조용히 버려진다]
- 문단 정렬은 문단의 style 안에 넣는다. 문단 객체에 평평하게 넣으면 버려진다
- 글자색·형광·폰트는 노드의 style 안에 각각 다른 이름으로 들어간다.
  실제 이름은 5번에서 읽은 구조를 보고 그대로 따라라. 추측하지 마라
- 이미지에는 원래 정렬 속성이 없다. 넣으면 남으므로 반드시 넣어라
- 이미지 캡션은 객체가 아니라 문단 배열 그 자체인 경우가 있다.
  5번에서 읽은 형식을 그대로 따라라

[이미지]
- 파일 선택 창은 프로그램이 다룰 수 없다.
  파일 입력 요소에 직접 파일을 넣는 방식(set_input_files)을 써라
- 업로드가 끝나면 다시 getDocumentData() 로 이미지 객체를 회수해서
  우리가 원하는 위치에 재배치한 뒤 다시 주입해라

[카테고리·태그·예약]
- 발행 창을 열고 카테고리를 선택한다. 카테고리 이름은 설정에서 읽어오게
- 태그는 입력 후 엔터를 눌러야 확정되는 경우가 많다. 하나씩 넣고 확인해라
- 예약 발행이면 날짜와 시각을 지정한다. 지정 후 값이 실제로 반영됐는지
  화면에서 다시 읽어 확인해라

[발행 — 여기가 제일 자주 틀린다]
- 발행은 2단계다. 툴바의 버튼을 누르면 레이어가 뜨고,
  그 레이어 안의 확인 버튼을 또 눌러야 실제로 나간다.
  첫 번째만 누르고 성공으로 기록하면 임시저장 상태로 남는다
- 두 번째 버튼을 누른 뒤 주소가 바뀌는 것을 기다려라

[성공 판정 — 절대 이렇게만 해라]
- 주소 모양으로 판정하지 마라. 임시저장도 비슷한 주소가 나온다
- 발행된 주소를, 로그인하지 않은 상태로 다시 열어서 확인해라.
  (쿠키를 싣지 않은 별도 요청)
- 200 이 와도 "삭제되었거나", "존재하지 않" 같은 안내 문구가 본문에 있으면 실패다
- 성공했을 때만 장부에 기록해라

[마지막]
- 실패하면 어느 단계에서 실패했는지 로그에 남기고 종료코드를 다르게 줘라
- 성공하면 주소를 출력해라
- 이 파일을 실행하는 명령과, 성공했을 때 화면에 무엇이 나오는지 알려줘
한 번에 안 되면 나눠서
위 지시문이 한 번에 안 돌아가는 게 정상입니다. 그럴 때는 절차를 쪼개서 시키세요. 아래 순서로 하나씩 확인하면 어디서 막히는지 바로 보입니다.
발행이 한 번에 안 돼서 단계별로 확인하려고 해.
아래를 하나씩 확인하는 작은 스크립트를 만들어 줘. 한 번에 하나씩만.

1단계 — 브라우저가 로그인 상태로 열리나
   글쓰기 페이지를 열고, 로그인 페이지로 튕기지 않는지 확인하고 화면을 캡처

2단계 — 편집 영역을 잡을 수 있나
   프레임을 찾고, 그 안에서 제목 입력 자리를 찾았는지 출력

3단계 — 에디터 객체를 찾을 수 있나
   window 를 훑어서 문서 모델을 읽고 쓰는 함수를 가진 객체를 찾고 이름을 출력
   찾으면 현재 문서 구조를 파일로 저장 (이게 우리 정답지다)

4단계 — 아주 짧은 글을 주입할 수 있나
   문단 하나짜리 문서를 주입하고 화면에 보이는지 캡처. 저장은 하지 마라

5단계 — 이미지 하나를 올릴 수 있나
   파일 하나를 올리고, 문서 구조에서 이미지 객체를 회수해 출력

각 단계마다 성공하면 무엇이 보여야 하는지 알려줘.
내가 결과를 알려주면 다음 단계로 넘어가자.
에디터 객체 이름은 서비스마다 다르고 업데이트로 바뀝니다. 그래서 이름을 책에 적어두면 언젠가 틀린 책이 됩니다. 대신 찾는 방법을 적었습니다. 문서 모델을 읽고 쓰는 함수를 모두 가진 객체를 훑어서 찾는 방식이면, 이름이 바뀌어도 그대로 동작합니다.
그리고 3단계에서 저장한 현재 문서 구조가 정답지입니다. 손으로 글 하나를 만들어 저장한 뒤 그 구조를 꺼내 보면, 어떤 필드에 무엇이 들어가는지가 전부 보입니다. 추측할 필요가 없습니다.
CHAPTER 16.7
처음부터 끝까지 한 번 — 리허설
부품이 다 있어도 한 번에 이어보지 않으면 돌아가는지 모릅니다.
여기까지 만들었으면 한 바퀴를 손으로 돌려보는 날을 하루 잡으세요. 자동 실행을 걸기 전에요. 순서대로 실행하면서 각 단계의 결과 파일을 눈으로 확인합니다.
지금까지 만든 것을 처음부터 끝까지 한 번 이어서 돌려보려고 해.
아직 자동 실행은 안 걸었고, 내가 손으로 하나씩 실행할 거야.

순서대로 실행할 명령을 알려줘. 그리고 각 단계마다
- 실행 명령
- 성공하면 화면에 나오는 것
- 성공하면 어느 파일이 생기고 그 안에 뭐가 있어야 하는지
- 실패하면 흔한 원인 두 가지

이 순서로 부탁해.
1) 배치 시작 (실행 문맥 만들기)
2) 수집
3) 판정 (몇 건이 왜 떨어졌는지 보이게)
4) 생성
5) 검수
6) 조립
7) 상한 확인
8) 발행 — 단, 이번에는 비공개나 임시저장으로만 해보고 싶어.
   실제로 공개하지 않고 여기까지 되는지 확인하는 방법을 알려줘
9) 발행했다면 성공 판정 확인

마지막에 전체를 한 번에 돌리는 명령도 알려줘.
그 명령이 앞으로 매일 자동 실행될 것이야.
리허설에서 조립까지 확인한 뒤, 첫 한 건은 눈으로 보고 내보내는 걸 권합니다. 규격이 실제로 어떻게 보이는지, 이미지가 어디에 붙었는지는 화면으로 봐야 감이 옵니다.
두 번째부터 자동으로 넘기세요. 그리고 자동으로 넘긴 뒤에도 첫 일주일은 매일 한 번씩 결과물을 열어 보세요.
자동으로 넘기기 전 체크
- 로그인 상태가 프로필 폴더에 저장돼 있고, 재로그인 없이 열린다
- 브라우저 창이 작업을 방해하지 않는다 (화면 밖으로 나간다)
- 이전 글 복구 창이 떠도 새로 작성으로 넘어간다
- 제목·본문·이미지·카테고리·태그가 전부 들어간다
- 발행 버튼을 두 번 누른다
- 성공 판정을 로그인하지 않은 상태로 한다
- 실패하면 어느 단계인지 로그에 남는다
- 같은 프로필로 두 프로세스가 동시에 열리지 않게 잠금이 걸려 있다
죽지 않게 한다
무인 파이프라인은 반드시 죽습니다. 문제는 죽는 게 아니라 죽은 채로 오래 있는 것입니다.
CHAPTER 17
스케줄러
손으로 실행하는 스크립트는 아무리 좋아도 도구지 파이프라인이 아닙니다.
진입점은 하나로
스케줄러에 여러 스크립트를 각각 등록하지 마세요. 순서가 꼬이고, 하나가 실패해도 다음이 그냥 돕니다. 진입점 하나만 등록하고 그 안에서 순서를 관리합니다.
daily/run_daily.py 를 만들어 줘. 스케줄러가 부르는 단 하나의 파일이야.

- 작업 폴더와 출력 인코딩을 이 파일에서 직접 세워 줘.
  스케줄러는 환경변수도 작업 폴더도 안 물려줘서, 손으로 돌릴 땐 되던 게
  예약으로는 안 되는 이유가 거의 이거야
- 단계를 순서대로 실행하되, 단계마다 "이 종료코드는 정상" 을 선언할 수 있게
  (후보 없음 5, 상한 도달 3 은 실패가 아니야)
- 정상 종료코드가 나오면 조용히 배치를 끝내고, 진짜 실패일 때만 알림
- 실행 전에 잠금을 걸어 중복 실행을 막아 줘

그리고 이걸 매일 정해진 시각에 자동 실행하는 방법을 알려줘.
내 운영체제는 (윈도우 / 맥) 이야. 화면에 보이는 대로 알려줘.
윈도우면 창이 안 뜨는 방식으로 등록하는 법을 꼭 알려줘.
그리고 컴퓨터가 꺼져 있었거나 재부팅됐을 때 놓친 작업을 나중에
실행하게 하는 설정도 어디서 켜는지 알려줘.
후보가 없는 날(5)이나 상한이 찬 경우(3)는 실패가 아니라 정상 상태입니다. 이걸 실패로 처리하면 알림이 매일 오고, 알림이 매일 오면 아무도 안 봅니다. 지시문처럼 단계별로 허용 코드를 선언해 두세요.
윈도우 등록
schtasks /create /tn "AUTO\daily" ^
  /tr "\"C:\Python312\pythonw.exe\" \"C:\auto\daily\run_daily.py\"" ^
  /sc daily /st 09:20 /f
실행될 때마다 검은 콘솔 창이 뜹니다. 작업 중에 포커스를 뺏고, 사용자가 무심코 닫으면 그날 배치가 죽습니다. pythonw.exe로 등록하세요.
스케줄러의 실행 명령 칸에는 길이 제한이 있습니다(윈도우는 261자). 경로와 인자가 길어지면 조용히 잘립니다. 에러가 아니라 뒤쪽 인자가 사라진 채로 실행됩니다. 진입점 하나만 등록하는 이유가 이것이기도 합니다.
놓친 실행을 나중에 돌리게 하기
위 명령만으로는 컴퓨터가 꺼져 있던 시간대의 작업이 그냥 사라집니다. 이 옵션은 설정 화면에서 체크할 수도 있지만, 화면을 열 일이 없습니다. 명령으로 켜면 됩니다.
내가 만든 진입점을 매일 정해진 시각에 자동 실행되게 등록해 줘.
등록도 네가 명령으로 해줘. 설정 화면을 여는 방법 말고, 명령으로.

내 운영체제는 (윈도우 / 맥) 이고, 작업 폴더는 (경로를 적으세요) 야.
실행 시각은 매일 (시각) 로.

[윈도우면]
- 창이 안 뜨게 pythonw 로 등록해 줘
- 관리자 권한 없이 등록되게 해 줘
- 다음 옵션을 반드시 켜 줘. 화면에서 체크하지 말고 등록할 때 같이 넣어줘
    · 예약 시간을 놓친 경우 가능한 한 빨리 실행 (StartWhenAvailable)
    · 배터리로 돌 때도 실행 (노트북이면)
    · 실행 시간이 너무 길면 중단 (무한정 물고 있지 않게)
- 이 옵션들을 명령 한 줄로 못 넣으면 XML 로 정의해서 등록하는 방식으로 해 줘

[맥이면]
- 로그인 시 자동으로 올라오게 등록해 줘
- 컴퓨터가 자면 예약이 안 도니, 절전 설정을 어떻게 확인하는지도 알려줘

[등록 후]
- 등록이 됐는지 확인하는 명령
- 지금 당장 한 번 실행해 보는 명령 (다음 날까지 기다리지 않게)
- 마지막 실행 결과와 시각을 확인하는 명령
- 등록을 지우는 명령

전부 내가 복사해서 붙여넣을 수 있는 형태로 줘.
예약이 지워지거나 꺼지는 일이 실제로 생깁니다. 시스템 업데이트나 계정 설정 변경으로요. 그래서 등록 내용을 파일로 저장해 두고 그 파일로 다시 등록하는 방식이 낫습니다. 위 지시문에서 XML로 등록하라고 한 이유가 이것입니다. 19장의 가드가 예약 자체를 확인하고 되살리게 만들 수도 있습니다.
업데이트나 정전으로 재부팅되면 그 시간대 작업은 그냥 건너뜁니다. 다음 날까지 아무 일도 안 일어나고, 아무도 모릅니다.
두 가지를 켜세요. 놓친 작업을 나중에 실행하는 옵션(StartWhenAvailable), 그리고 로그인 없이도 돌게 하는 설정. 로그인 화면에서 멈춰 있으면 GUI가 필요한 작업은 전부 0회 실행입니다.
맥이라면
<?xml version="1.0" encoding="UTF-8"?>
<plist version="1.0"><dict>
  <key>Label</key><string>com.me.auto.daily</string>
  <key>ProgramArguments</key>
  <array>
    <string>/usr/bin/python3</string>
    <string>/Users/me/auto/daily/run_daily.py</string>
  </array>
  <key>StartCalendarInterval</key>
  <dict><key>Hour</key><integer>9</integer>
        <key>Minute</key><integer>20</integer></dict>
  <key>StandardOutPath</key><string>/tmp/auto.out.log</string>
  <key>StandardErrorPath</key><string>/tmp/auto.err.log</string>
</dict></plist>
맥의 launchd는 로그인 셸의 PATH를 안 물려줍니다. 스크립트 안에서 외부 명령을 부르면 "명령을 찾을 수 없음"으로 전부 실패합니다. 우리는 이것 때문에 하루치 배치가 통째로 스킵된 적이 있습니다. 외부 명령은 절대경로로 부르거나, 진입점에서 PATH를 명시적으로 세우세요.
CHAPTER 18
락과 동시성
중복 실행을 막는 코드가 오히려 파이프라인을 멈추는 경우가 있습니다.
왜 락이 필요한가
배치가 예상보다 오래 걸리면 다음 실행이 겹칩니다. 그러면 같은 소재로 두 개가 나가거나, 중간 파일을 서로 덮어씁니다. 그래서 락을 겁니다.
"만든 지 N시간 지나면 무시"처럼 나이로만 판정하면, 프로세스가 크래시한 뒤 그 N시간 동안 아무것도 안 돕니다. 락은 남아 있는데 주인은 죽어 있는 상태입니다. 락에 PID를 적고, 그 PID가 살아 있는지 확인하세요.
daily/lock.py 를 만들어 줘. 중복 실행을 막는 잠금이야.

- 잠금 파일에 프로세스 번호를 적고, 그 프로세스가 살아 있는지 확인해 줘
- 죽어 있으면 즉시 잠금을 회수해 줘
- 시간만으로 판정하면 안 돼. 프로그램이 비정상 종료하면
  그 시간 동안 아무것도 안 돌아서 반나절이 날아가
- 다만 프로세스 번호는 재사용될 수 있으니, 너무 오래된 잠금은
  살아 있어 보여도 회수하는 2차 장치도 넣어 줘
- 잠금 파일도 임시 파일에 쓰고 바꿔치기하는 방식으로
운영체제는 PID를 재사용합니다. 죽은 프로세스의 PID를 나중에 다른 프로그램이 쓸 수 있어요. 그러면 _alive가 참을 돌려주고 락이 영원히 안 풀립니다. 그래서 나이 상한을 2차로 같이 둡니다. 1차는 PID, 2차는 나이입니다. 순서가 중요합니다.
여러 프로세스가 같은 파일을 고칠 때
가드나 다른 자동화가 동시에 도는 환경이면, 상태 파일에 대한 동시 쓰기가 생깁니다. 세 가지로 막습니다.
- 원자적 쓰기(임시 파일 + 교체). 6장 캐시에서 이미 썼습니다.
- 추가 전용 파일을 우선 씁니다. 장부·저널은 줄 단위 append가 안전합니다.
- 같은 파일을 고치는 주체를 하나로 줄입니다. 이게 제일 좋습니다.
CHAPTER 19
자가복구
알림만 오게 만들면 알림을 못 본 날은 그냥 하루가 날아갑니다. 감지가 아니라 복구까지 가야 합니다.
판정의 단위 — 증거
가드는 "돌았는가"를 어떻게 아나. 결과물이 아니라 증거 파일로 압니다. 항목마다 "이 일이 제대로 끝났다면 이 파일이 오늘 것이어야 한다"를 하나씩 정합니다.
daily/guard.py 를 만들어 줘. 죽었는지 확인하고 직접 되살리는 기능이야.
30분마다 자동 실행할 거야.

- 항목마다 "이 일이 제대로 끝났다면 이 파일이 오늘 것이어야 한다" 는
  증거 파일을 하나씩 정해서 목록으로 관리해 줘
- 파일이 있는지만 보지 말고, 크기가 최소 이상인지와 오늘 날짜인지까지 확인.
  실패해도 빈 파일은 생기거든
- 문제가 있으면 알림만 보내지 말고 그 단계를 직접 다시 실행해 줘
- 다시 실행해도 안 되면 그때만 알림을 보내
- 증거 파일을 정할 수 없는 항목은 아예 목록에 넣지 마.
  결과가 파일로 안 남으면 30분마다 무한히 다시 실행하게 돼

이걸 30분마다 자동 실행하는 등록 방법도 알려줘.
가드가 무언가를 복구했는데 그 결과가 파일로 남지 않으면, 다음 판정에서 또 실패로 잡히고 무한히 되살립니다. 30분마다 같은 작업이 반복 실행되면서 API 사용량만 씁니다.
증거를 정할 수 없는 항목은 애초에 자동 판정 대상이 아닙니다. 판정 대상에서 빼거나, 그 작업이 증거를 남기도록 고치세요.
수집이 0건으로 끝나도 빈 파일은 생깁니다. 존재만 확인하면 통과합니다. 크기나 내용까지 봐야 합니다. 지시문에 최소 크기 확인을 넣은 이유입니다.
가드가 놓치는 것
가드는 파일을 봅니다. 그래서 파일을 안 남기는 종류의 죽음은 못 잡습니다. 대표적으로 상주 프로세스가 재부팅 뒤 안 돌아온 경우입니다. 이건 별도로 확인해야 합니다.
CHAPTER 20
알림 설계
알림이 매일 오면 아무도 안 봅니다. 그러면 알림이 없는 것과 같습니다.
언제 사람을 부르나
| 상황 | 알림 | 이유 |
|---|---|---|
| 배치 성공 | 보내지 않는다 | 매일 오는 알림은 무시된다 |
| 후보 전멸 | 보내지 않는다 | 정상 상태다. 여러 날 연속이면 그때 |
| 상한 도달 | 보내지 않는다 | 관문이 제 일을 한 것이다 |
| 단계 실패 | 가드에 맡긴다 | 가드가 되살리면 알릴 일이 아니다 |
| 복구까지 실패 | 보낸다 | 사람 말고 할 수 있는 게 없다 |
| 연속 N일 이상 | 보낸다 | 추세는 사람이 봐야 한다 |
daily/notify.py 를 만들어 줘. 알림을 보내는 기능인데,
도배를 막는 게 이 파일의 절반이야.

- 같은 내용의 알림은 6시간에 한 번만 보내게 (내용을 해시로 비교)
- 보낸 기록을 파일에 남기고, 임시 파일 방식으로 안전하게 저장
- 알림 설정이 없으면 그냥 로그에만 남기고 조용히 넘어가게

그리고 어떤 상황에 알림을 보낼지 정리해 줘.
- 성공, 후보 없음, 상한 도달: 보내지 않는다 (매일 오면 아무도 안 봐)
- 단계 실패: 감시 기능이 되살리게 두고 보내지 않는다
- 되살리기까지 실패했을 때만 보낸다

텔레그램으로 보내는 방법도 알려줘. 봇을 만들고 내 채팅 아이디를
알아내는 절차를 화면에 보이는 대로 순서대로 알려줘.
건별로 보내면 도배가 됩니다. 실패를 파일에 쌓아두고 정해진 시각에 한 통으로 묶어 보내는 방식이 실전에서 훨씬 낫습니다. 즉시 알림은 "지금 사람이 안 오면 손해가 커지는 것"에만 씁니다.
"실패하면 알림이 오니까, 알림이 없으면 성공"이라고 생각하기 쉽습니다. 그런데 알림 발송 자체가 실패하면 그 논리가 무너집니다. 그리고 알림 코드에 버그가 있으면 영원히 조용합니다.
성공은 알림의 부재가 아니라 증거 파일로 판정하세요. 알림은 보조 수단입니다.
나아지게 한다
대부분의 자동화가 여기서 멈춥니다. 재기까지는 하는데, 잰 값이 집행까지 닿지 않습니다.
CHAPTER 21
측정 설계
측정은 대시보드를 만드는 일이 아닙니다. 다음 결과물의 규격을 바꿀 근거를 모으는 일입니다.
재기 전에 답해야 하는 질문
지표마다 "이게 바뀌면 무엇을 바꿀 건가"에 답이 있어야 합니다. 답이 없으면 재지 마세요. 재는 것 자체가 비용이고, 무엇보다 화면이 복잡해지면 정작 중요한 게 안 보입니다.
| 파일 | 한 줄에 | 이 값이 바꾸는 것 |
|---|---|---|
metrics.csv | 날짜, 결과물 ID, 조회수, 나이 | 소재 선정, 제목 규칙 |
inflow.csv | 날짜, 유입 경로, 비율 | 어느 층을 고칠지 (22장) |
stats.csv | 결과물의 속성 전부 | 규격 자체 (23장) |
qa_stats.jsonl | 검수 위반 종류·횟수 | 프롬프트 |
속성을 남기는 게 핵심입니다
stats.csv가 학습의 입력입니다. 결과물마다 그때 어떤 규격으로 만들었는지를 같이 적어야 나중에 무엇이 효과가 있었는지 가릴 수 있습니다. 조회수만 남기면 아무것도 못 배웁니다.
date,post_id,axis,category,keyword,vol,docs,ratio,mobile,
title_len,title_form,body_chars,blocks,line_avg,images,
variant,published_at,batch_id

- 판정 근거(vol/docs/ratio/mobile)를 같이 남긴다.
  나중에 "비율이 높은 소재가 실제로 잘 됐나" 를 확인할 수 있다.
- variant 는 실험 배정값이다(24장).
- batch_id 가 있어야 문제가 생겼을 때 그 배치를 재현할 수 있다.
제목을 따옴표 없이 CSV에 썼습니다. 제목에 쉼표가 들어간 날 칸이 한 칸씩 밀려서 category 자리에 제목 길이 숫자가 들어갔습니다. 그리고 학습 층이 그걸 읽고 best_category='36'을 프롬프트에 먹이고 있었습니다. 며칠 동안요.
쓸 때는 CSV 모듈로 따옴표를 붙이고, 읽을 때는 화이트리스트로 검증하세요. 한쪽만 고치면 안 됩니다.
측정 단계를 만들어 줘. daily/store.py 와 daily/maturity.py.

[store.py] 통계 저장과 읽기
- CSV 로 저장하되 반드시 csv 모듈로 따옴표 처리를 해줘.
  제목에 쉼표가 들어가면 칸이 밀려서, 엉뚱한 값이 다른 칸에 들어가
- 읽을 때는 축 이름 같은 값을 미리 정한 목록과 대조해서
  이상한 줄은 아예 빼줘. 밀린 줄이 학습에 들어가면 조용히 오염돼
- 저장할 항목: 날짜, 결과물 아이디, 축, 카테고리, 키워드,
  판정 근거 네 개(검색량·문서수·비율·모바일), 제목 길이, 제목 형태,
  본문 길이, 블록 수, 평균 줄 길이, 이미지 수, 실험 배정값,
  발행 시각, 배치 아이디

[maturity.py] 성숙도
- 발행 후 며칠이 지났는지 계산
- 3일이 안 된 것은 학습에 넣지 않게 판정하는 함수
- 누적 조회수가 아니라 하루당 조회수를 계산하는 함수.
  누적으로 순위를 매기면 먼저 나간 게 무조건 이겨서
  발행 순서를 실력으로 착각하게 돼
성숙도 — 덜 자란 숫자는 성적이 아니다
발행 15분 뒤의 조회수 0을 기준값 후보에 넣고 있었습니다. 아무 의미가 없는 값입니다. 최소 며칠은 재우고 판정하세요.
그리고 누적 지표로 순위를 매기면 먼저 나간 것이 무조건 이깁니다. 발행 순서를 실력으로 착각하게 돼요. 나이로 나눠서 보세요.
유입 경로를 반드시 재세요
우리는 유입이 100% 검색이라고 가정하고 몇 주를 보냈습니다. 계측을 켜자마자 추천 피드가 전체 유입의 26%로 잡혔습니다. 없던 게 아니라 안 재고 있었던 겁니다.
그리고 그 26%는 검색 지수와 무관하게 노출되는 유일한 경로였습니다. 신생 계정에는 이게 제일 큰 자리였어요. 안 쟀으면 계속 검색만 붙들고 있었을 겁니다.
일부 통계 API는 서명 헤더를 요구해서 직접 호출하면 거부당합니다. 서명을 흉내내려 하지 마세요 — 규격이 바뀌면 같이 죽고, 대개 약관에도 걸립니다.
그 화면이 스스로 부르는 응답을 가로채는 방법이 낫습니다. 통계 화면은 열리자마자 필요한 호출을 합니다. 브라우저 자동화의 네트워크 이벤트로 그 응답만 받아 저장하면 됩니다. 우리 경우 한쪽 API는 서명이 필요했고 다른 쪽은 아니어서, 필요한 것만 이 방식으로 처리했습니다.
CHAPTER 22
진단
병목을 틀리면 그 뒤의 모든 노력이 헛수고가 됩니다. 우리가 그랬습니다.
일어난 일
결과물의 모양을 대대적으로 개조했습니다. 벤치마크를 재서 줄 길이·블록·이미지 수·정렬·소제목을 전부 맞췄어요. 반나절이 들었습니다. 그날 저녁에 측정해보니 유입이 그대로였습니다.
진단해보니 이유가 명확했습니다. 우리가 고친 항목은 전부 "노출된 다음"에 효과가 나는 것들이었습니다. 그런데 그때 병목은 노출 자체였어요. 클릭률을 아무리 올려도 노출이 0이면 0입니다.
| 단계 | 확인 방법 | 0이면 고칠 곳 |
|---|---|---|
| 1. 색인 | 제목 그대로 검색해서 나오나 | 기술적 문제. 접근 설정·robots |
| 2. 순위 | 실제 검색어로 1~2페이지에 있나 | 소재 선정(2부) |
| 3. 노출 | 유입 경로별 노출 수 | 주제 분류·피드 진입 조건 |
| 4. 클릭 | 노출 대비 유입 | 제목·썸네일(11장) |
| 5. 체류 | 평균 체류·이탈 | 결과물 모양(3부) |
| 6. 전환 | 클릭·주문·구독 | 배치·문구·가격대 |
위에서부터 봅니다. 2번이 0인데 5번을 고치면 아무 일도 안 일어납니다.
daily/diagnose.py 를 만들어 줘. 어디가 병목인지 찾는 기능이야.

층을 순서대로 보고, 위에서부터 처음 0 인 곳이 병목이야.
1) 색인 — 제목 그대로 검색해서 나오나
2) 순위 — 실제 검색어로 앞쪽에 있나
3) 노출 — 유입 경로별 노출
4) 클릭 — 노출 대비 유입
5) 체류
6) 전환

결과를 diagnosis.json 에 저장하고, 병목이 어디인지 한 줄로 알려줘.

왜 필요한지 말해줄게. 우리는 결과물 모양을 반나절 걸려 개조했는데
유입이 그대로였어. 고친 항목이 전부 "노출된 다음에" 효과가 나는
것들이었는데, 그때 병목은 노출 자체였거든.
2번이 0 인데 5번을 고치면 아무 일도 안 일어나.
제목을 통째로 검색하면 대부분 나옵니다. 그래서 "색인 정상"으로 판정하고 안심합니다. 그런데 제목 전체를 검색하는 사람은 없습니다. 색인과 순위는 완전히 다른 층이에요. 실제 검색어로 확인하지 않으면 이 구분이 안 보입니다.
우리는 8건 중 7건이 제목 검색으로 나왔고, 같은 8건이 실제 검색어로는 0건이었습니다.
진단은 정기적으로, 자동으로
진단을 사람이 생각날 때 하면 안 됩니다. 매일 돌려서 파일로 남기고, 병목이 바뀌면 그때 알립니다. 병목이 바뀌었다는 건 앞 층이 풀렸다는 뜻이라 좋은 소식입니다.
CHAPTER 23
학습과 롤백
되돌릴 수 없는 변경은 학습이 아니라 도박입니다.
폐루프의 조건 셋
- 바꿀 대상이 파일이어야 한다. 6장의
tuning.json, 10장의style_spec.json이 그 자리입니다. 코드 상수는 학습이 못 바꿉니다. - 바꾸기 전 값을 같이 남긴다. 안 남기면 되돌릴 수 없습니다.
- 판정 시점을 미리 정한다. 며칠 뒤에 볼지, 표본 몇 건이 차야 볼지. 안 정하면 영원히 "아직 모르겠다"가 됩니다.
daily/evolve.py 를 만들어 줘. 성과를 보고 기준값을 바꾸되,
효과가 없으면 자동으로 되돌리는 기능이야.

- 기준값을 바꿀 때 반드시 세 가지를 같이 기록해 줘
  · 바꾸기 전 값 (이게 없으면 되돌릴 수가 없어)
  · 바꾸기 전 성적
  · 며칠 뒤에 판정할지 (5일 뒤)
- 기록은 한 줄에 하나씩 쌓이는 파일로
- 판정일이 되면 성적을 비교해서, 나아졌으면 유지하고
  아니면 이전 값으로 자동으로 되돌려 줘
- 표본이 8건이 안 되면 판정하지 말고 "표본이 안 찼다" 고 말하고
  판정일을 미뤄 줘. 억지로 판정하면 잡음을 따라가
- 기준값 파일도 임시 파일 방식으로 안전하게 저장

한 번에 하나씩만 바꾸게 해줘. 여러 개를 동시에 바꾸면
뭐가 효과였는지 영원히 몰라.
같은 날 기준값 셋을 동시에 바꾸면 무엇이 효과였는지 영원히 모릅니다. 그리고 롤백할 때도 셋을 다 되돌려야 합니다. 변경은 한 번에 하나, 판정 기간이 끝나기 전에는 그 항목을 다시 안 건드립니다.
우리는 학습 스크립트가 매일 도는데 정작 규격은 몇 주 전 값에 멈춰 있던 적이 있습니다. 학습이 계산은 하는데 결과를 아무도 읽지 않는 파일에 쓰고 있었어요. 생성 단계가 그 파일을 안 읽고 있었습니다.
학습을 붙였으면 그 값이 실제로 프롬프트나 판정에 들어가는지 한 번은 확인하세요. 확인 방법은 간단합니다 — 값을 극단으로 바꾸고 결과가 달라지는지 봅니다.
학습이 바꿀 만한 것들
| 대상 | 신호 | 조정 방향 |
|---|---|---|
| 비율 하한 | 통과분이 너무 적다 / 통과분 성적이 나쁘다 | 내린다 / 올린다 |
| 검색량 하한 | 1위인데 유입이 없다 | 올린다 |
| 본문 길이 | 길이 구간별 체류 차이 | 중앙값을 옮긴다 |
| 이미지 수 | 구간별 이탈률 | 목표를 옮긴다 |
| 제목 형태 | 변형별 클릭률(24장) | 승자 쪽으로 |
CHAPTER 24
실험 설계
A/B를 붙여놓고 몇 달째 "표본이 안 차서 판정을 못 한다"에 갇히는 경우가 아주 흔합니다.
표본은 발행량이 아니라 배정으로 채운다
변형 두 개를 번갈아 배정하면, 항목 하나를 판정하는 데 필요한 발행량이 그대로 필요합니다. 항목이 세 개면 세 배가 됩니다. 그래서 표본이 안 찹니다.
대신 여러 항목을 직교로 배정하면 같은 발행량으로 표본이 몇 배가 됩니다. 각 결과물이 여러 실험에 동시에 참여하는 겁니다.
daily/experiment.py 와 daily/ab_judge.py 를 만들어 줘.

[experiment.py] 배정
- 여러 항목을 동시에 실험할 수 있게 직교로 배정해 줘.
  번갈아 배정하면 항목마다 표본이 따로 필요해서 영원히 안 차는데,
  직교로 하면 같은 발행량으로 표본이 몇 배가 돼
- 배정에 난수를 쓰지 마. 결과물 아이디를 해시해서 결정적으로 정해 줘.
  실패한 배치를 다시 돌릴 때 배정이 바뀌면 데이터가 오염돼

[ab_judge.py] 판정
- 성숙한 것만, 하루당 조회수로 비교
- 한쪽 표본이 8건이 안 되면 "판정 보류" 로 표시
- 차이가 15% 미만이면 무승부로 두고 표본을 더 모아 줘.
  작은 차이는 잡음인데 그걸 승자로 채택하면 규격이 계속 흔들려
실패한 배치를 다시 돌릴 때 배정이 달라지면 그 결과물의 데이터가 오염됩니다. 결과물 키의 해시로 배정하면 언제 다시 돌려도 같은 배정이 나옵니다. 2장에서 시각·난수를 앞으로 뺀 것과 같은 원리입니다.
오염원 셋
댓글 수를 지표로 쓰는데 자동 응대가 켜져 있으면, 내가 단 답글이 내 성과로 잡힙니다. 결과물이 좋아서 반응이 는 게 아니라 기계가 답을 달아서 늘어난 건데, 학습은 그걸 구분 못 합니다. 반응을 셀 때 내 계정이 만든 것은 반드시 빼세요.
누적 지표로 변형을 비교하면 먼저 나간 쪽이 무조건 이깁니다. 실험 초반에 A가 많이 나갔으면 A가 이깁니다. 나이로 나눈 값을 쓰거나, 같은 나이 구간끼리만 비교하세요.
제목 실험을 돌리는 중에 규격을 개조하면 결과가 무의미해집니다. 어느 쪽 영향인지 모르니까요. 실험 기간에는 그 실험이 건드리는 항목 외에는 고정합니다. 23장의 저널에 "지금 진행 중인 실험" 목록을 남겨두면 실수를 줄입니다.
판정
표본이 작을 때 5% 차이는 그냥 잡음입니다. 그걸 승자로 채택하면 규격이 잡음을 따라 계속 흔들립니다. 일정 비율 이상 벌어졌을 때만 승부를 인정하고, 아니면 무승부로 두고 표본을 더 모으세요.
관찰에는 만기가 있어야 한다
"좀 더 지켜보자"는 상태가 영원히 지속되면 그건 관찰이 아니라 방치입니다. 실험마다 만기를 정하세요 — 날짜든 표본 수든. 만기가 되면 판정하거나, 못 찼다고 명시적으로 말하고 실험을 접습니다.
지키고 늘린다
스물네 장을 다 만들어도 계정이 막히면 전부 0이 됩니다.
CHAPTER 25
안전선
이 장은 기술이 아니라 판단의 문제입니다. 사실만 적고 판단은 남깁니다.
알아야 할 사실
- 여러 플랫폼이 공식 발행 API를 종료했습니다. 정식 자동 발행 경로가 없는 곳이 많습니다.
- 운영정책에 자동 프로그램 사용·유포가 금지 항목으로 명시된 곳이 다수입니다.
- 제재는 단계적입니다. 노출 강등 → 게시물 비공개 → 기간 정지 → 접근 제한.
- 브라우저 자동화에 대한 탐지가 강화됐다는 보고가 오픈소스 쪽에 반복적으로 올라옵니다.
발행 자동화는 4.5부 세 장입니다. 나머지 서른여덟 장 — 도구·전략·판정·규격·측정·학습·자가복구 — 은 정책과 아무 관계가 없고, 발행을 손으로 하더라도 그대로 유효합니다.
그리고 실제로 성과를 가른 것도 그쪽이었습니다. 우리가 유입 0에서 벗어난 건 발행을 자동화해서가 아니라 소재 판정을 붙여서였습니다.
발행량이 가장 큰 신호입니다
16장의 상한 관문이 안전선의 핵심입니다. 여기서는 그 이유를 조금 더 적습니다.
| 시각 | 조회수 | 비고 |
|---|---|---|
| 14:00 | 1,460 | 그날 첫 발행 |
| 22:00 | 0 | 재고를 한꺼번에 소진 |
| 22:30 | 1 | |
| 23:00 | 1 |
같은 날, 같은 계정, 같은 파이프라인입니다. 물량을 늘린 게 아니라 편당 효율을 버린 것이었습니다.
인간화 — 하지 말아야 할 다섯
- 고정 간격으로 요청하지 마세요. 정확히 같은 간격이 제일 티가 납니다. 3장의
net.get이 간격을 흔드는 이유입니다. - 정확히 같은 시각에 매일 실행하지 마세요. 16장의 지터를 쓰세요.
- 새 로그인을 반복하지 마세요. 이미 인증된 세션을 유지하는 쪽이 신호가 적습니다. 세션을 강제 종료하면 쿠키가 날아가 재인증이 반복됩니다.
- 화면 없는 모드를 기본으로 쓰지 마세요. 탐지 표면이 큽니다. 화면이 필요하면 창을 화면 밖으로 보내는 편이 낫습니다.
- 사람이 쓰는 계정으로 실험하지 마세요. 실험은 실험용에서.
자동화를 정리한다고 브라우저를 강제 종료하면 세션 쿠키가 날아가고, 다음 실행에서 재인증이 필요해집니다. 재인증이 반복되면 그 자체가 이상 신호입니다. 인증된 창은 닫지 말고 재사용하세요.
소재 자체의 선
승산 게이트를 켜자마자 1위로 올라온 소재가 외모 품평 기사였습니다. 숫자로는 최고였어요. 그런데 그건 명예훼손 라인에 가깝고 플랫폼 선정성 필터에도 걸립니다.
게이트는 검색량과 문서수만 봅니다. 사람이 정한 선은 따로 박아야 합니다. 6장 anchor.py의 BLOCK 목록이 그 자리이고, 게이트보다 먼저 걸려야 합니다. 게이트를 통과한 뒤에 거르면 API 호출을 낭비합니다.
법적 표기
제휴 링크나 협찬이 들어가면 대가성 고지가 필요합니다. 그리고 그 위치가 중요합니다.
- 대가성 고지는 글 맨 앞에 둡니다. 뒤에 숨기면 그 자체가 더 큰 문제가 됩니다.
- 링크 안내 문구는 본문과 구분되게 둡니다.
- 문구가 사실과 어긋나지 않게 하세요. "이 사람이 쓴 그 제품"이 아니라 "비슷한 종류"라면 그렇게 써야 합니다. 여기서 말이 틀어지면 허위 광고가 됩니다.
CHAPTER 26
축을 늘릴 때
하나가 돌면 둘을 붙이고 싶어집니다. 두 번째부터 생기는 문제가 따로 있습니다.
축을 늘리기 전에 확인할 넷
- 총량을 그대로 두고 나눌 수 있나. 축이 늘면 발행량이 늘고, 발행량이 늘면 25장의 선을 넘습니다. 새 축은 기존 축의 자리를 뺏어야 합니다.
- 판정 기준이 정말 다른가. 기준이 같으면 그건 새 축이 아니라 같은 축의 다른 소재입니다. 괜히 나누면 관리 대상만 늘어납니다.
- 장부에서 구분되는가. 다음 항목에서 자세히 다룹니다. 이게 제일 자주 터집니다.
- 화자가 흔들리지 않는가. 같은 계정에서 서로 안 어울리는 주제가 섞이면 독자가 떠납니다.
새 축이 같은 계정·같은 장부를 쓰면, 두 축을 가르는 건 카테고리 칸 하나뿐입니다. 발행 스크립트가 그 칸을 다르게 적으면 결과물이 조용히 다른 축으로 새고, 새 축은 계속 "첫 발행 전"으로 남습니다.
틀려도 에러가 안 납니다. 축을 늘릴 때 제일 먼저 확인할 자리이고, 화이트리스트 검증(21장)을 반드시 걸어야 하는 이유입니다.
대시보드나 집계에 새 축을 첫 결과물보다 먼저 만들어 두세요. 축이 없으면 "아직 시작 안 한 것"과 "수집이 깨진 것"이 화면에서 똑같이 안 보입니다. 발행 전에는 '준비 중' 상태로 표시되게 하면 둘이 구분됩니다.
예약과 상태의 구분
예약을 걸어둔 것과 실제로 나간 것은 다릅니다. 예약을 발행으로 세면 상한 관문이 잘못 판정하고, 성과 집계도 틀어집니다.
상태를 셋으로 나누세요. 완료 / 예약 대기 / 확인 필요. 예약 시각이 지났는데도 공개 확인이 안 되면 그건 '확인 필요'이고, 사람이 봐야 하는 상태입니다.
"오늘 몇 건 했나"를 셀 때 초안 생성, 예약, 수집 같은 걸 같이 세면 숫자가 부풀려집니다. 우리는 17건이 38건으로 보인 적이 있습니다. 발행 건수는 실제로 공개된 것만 셉니다. 다른 것은 다른 칸에 셉니다.
축이 늘면 가드도 늘어야 한다
19장의 가드는 축별로 증거를 따로 봐야 합니다. 하나로 뭉뚱그리면 한 축이 죽어도 다른 축의 파일이 갱신돼서 통과합니다.
축 하나를 추가할 때 반드시 같이 만드는 것

  1. tuning.json 에 그 축의 판정 기준         (6장)
  2. spec 의 axis_override                     (10장)
  3. 제목 규칙의 축 분기                       (11장)
  4. quota.CAP 에 그 축의 상한                 (16장)
  5. guard.CHECKS 에 그 축의 증거 파일         (19장)
  6. store 의 화이트리스트에 축 이름           (21장)
  7. 집계·대시보드의 축 (첫 발행 전에)         (26장)

하나라도 빠지면 그 축은 조용히 다른 축에 섞이거나,
죽어도 아무도 모르는 상태가 된다.
수익 축을 늘릴 때 하나 더
커미션 1위 상품만 다뤘더니 클릭 115에 주문 0이었습니다. 200만원대 제품이었어요. 독자가 글을 읽다가 그 자리에서 200만원을 결제하지 않습니다.
전환은 커미션율이 아니라 결제까지의 거리가 가릅니다. 우리가 세 번째 축을 만든 이유가 이것입니다 — 10~30만원대라 거리가 짧습니다.
제휴사마다 최소 출금액이 있습니다. 단독으로 여러 곳에 붙으면 한 곳당 수십만원씩 쌓아야 하는데, 시작 단계 트래픽으로는 어느 벽도 못 넘고 한 푼도 못 받습니다.
여러 제휴사를 한 계정으로 묶어주는 중개 플랫폼이 있으면 합산으로 출금됩니다. 요율이 조금 낮아도 받을 수 있는 돈이 받지 못하는 돈보다 큽니다.
그리고 실적이 게시한 채널에 귀속되는지 링크를 발급한 계정에 귀속되는지 먼저 확인하세요. 모르고 붙이면 몇 주치 실적이 사라집니다.
마지막 — 무엇을 늘릴지보다 무엇을 접을지
축을 늘리는 것만 생각하면 관리 대상만 늘어납니다. 6개월쯤 지나면 안 되는 축을 접는 결정이 더 중요해집니다. 접는 기준을 미리 정해두세요 — 몇 달 안에 어떤 지표가 어디에 도달하지 못하면 접는다, 처럼.
그리고 접을 때는 24장의 만기와 같은 원칙입니다. "좀 더 지켜보자"가 영원히 지속되면 그건 결정을 안 한 것입니다.
부록
본문에 흩어진 것을 쓰기 좋게 모았습니다.
부록 A
우리가 밟은 함정 55개
이 목록만 피해도 몇 주를 아낍니다. 전부 실제로 겪은 것이고, 대부분 에러가 안 나는 종류입니다.
환경·공통
| # | 함정 | 대응 | 장 |
|---|---|---|---|
| 1 | 중간 산출물을 덮어써서 어제를 못 본다 | 배치 폴더에 남긴다 | 2 |
| 2 | 윈도우 콘솔 인코딩이 배치를 죽인다 | UTF-8 고정, 하위 프로세스에도 | 3 |
| 45 | 경로 끝 \r 로 파일 판정이 전부 실패 | 외부 경로는 무조건 strip | 3 |
| 48 | 공통 모듈 이름이 표준 라이브러리를 가린다 | 표준에 없는 이름을 쓴다 | 3 |
수집·판정
| # | 함정 | 대응 | 장 |
|---|---|---|---|
| 3 | 수집처 하나가 배치 전체를 죽인다 | 수집처별 try, 실패 수를 남긴다 | 4 |
| 4 | 중복 판정을 전체 문자열로 한다 | 앞 N자 또는 낱말 집합 | 4 |
| 5 | 광고 경쟁도를 SEO 경쟁도로 쓴다 | 경쟁도는 문서수로만 | 5 |
| 6 | 공백 든 키워드는 0이 아니라 측정 실패 | 공백을 붙여서 넣는다 | 6 |
| 7 | 최소 표시값을 0으로 읽는다 | 명시적으로 변환한다 | 6 |
| 8 | 따옴표 안에서 앵커를 뽑는다 | 인용 구간 선제거 후 바깥부터 | 6 |
| 9 | 게이트 통과 키워드가 제목에 없다 | 앞부분 강제 + 검수 확인 | 6 |
| 10 | 전멸했는데 억지로 채운다 | 빈 축을 허용한다 | 7 |
규격·생성
| # | 함정 | 대응 | 장 |
|---|---|---|---|
| 11 | 한 항목만 고치고 다 고쳤다고 믿는다 | 항목별로 따로 잰다 | 9 |
| 12 | 규칙을 문서에만 적어둔다 | 검수 함수로 존재하게 | 11 |
| 13 | 본문 추출 실패 시 HTML 전체 폴백 | 폴백 없이 소재를 버린다 | 12 |
| 46 | 구조화 출력을 JSON으로 받는다 | 구분자 방식으로 | 12 |
| 47 | 프롬프트에 참고 문서를 통째로 넣는다 | 무관한 절을 잘라낸다 | 12 |
조립·출고
| # | 함정 | 대응 | 장 |
|---|---|---|---|
| 14 | 좌표 클릭·합성 키로 글을 만든다 | 문서 모델을 주입한다 | 14 |
| 15 | 이미지에 정렬 필드가 없어 어긋난다 | 조립 때 주입한다 | 14 |
| 16 | 제목 낱말만으로 이미지를 고른다 | 설명 텍스트까지 대조 | 14 |
| 17 | 극단 비율 이미지가 레이아웃을 깬다 | 비율·해상도로 거른다 | 14 |
| 18 | 확인 버튼이 두 개인데 하나만 누른다 | 공개 확인으로만 판정 | 15 |
| 19 | 주소 모양으로 성공을 판정한다 | 비로그인 조회로 판정 | 15 |
| 20 | 제약 해제를 상한 제거로 옮긴다 | 상한을 코드 관문으로 | 16 |
| 21 | 하루 목표를 통째로 둔다 | 축별로 쪼갠다 | 16 |
| 22 | 우리 장부로 상한을 판정한다 | 실물을 센다 | 16 |
스케줄·생존
| # | 함정 | 대응 | 장 |
|---|---|---|---|
| 23 | 콘솔 창이 튀어나와 포커스를 뺏는다 | 창 없는 인터프리터로 등록 | 17 |
| 24 | 명령줄 길이 제한에 인자가 잘린다 | 진입점 하나만 등록 | 17 |
| 25 | 재부팅이 그날 배치를 삼킨다 | 놓친 작업 실행 + 자동 로그온 | 17 |
| 26 | PATH 가 없어 외부 명령이 전량 실패 | 절대경로 또는 진입점에서 설정 | 17 |
| 27 | 나이 기준 락이 반나절을 세운다 | PID 확인 후 회수 | 18 |
| 28 | 증거 없는 항목을 무한 복구한다 | 항목마다 증거 파일 지정 | 19 |
| 29 | 파일 존재만 보고 성공으로 친다 | 크기·내용까지 확인 | 19 |
| 30 | 알림의 부재를 성공으로 읽는다 | 증거로 판정, 알림은 보조 | 20 |
측정·학습
| # | 함정 | 대응 | 장 |
|---|---|---|---|
| 31 | CSV 칸 밀림이 학습을 오염시킨다 | 쓰기는 따옴표, 읽기는 화이트리스트 | 21 |
| 32 | 발행 직후 숫자를 실험 결과로 쓴다 | 성숙도 기준 + 나이로 나눈 값 | 21 |
| 33 | 색인 확인을 제목 전체로 한다 | 실제 검색어로 확인 | 22 |
| 34 | 잰 값이 집행까지 닿지 않는다 | 극단값으로 연결을 확인 | 23 |
| 35 | 내가 만든 반응이 성과로 되먹임된다 | 내 계정 반응은 제외 | 24 |
| 36 | 점수가 발행 순서를 따라간다 | 나이로 나눈 값으로 비교 | 24 |
| 37 | 실험 중에 다른 걸 바꾼다 | 실험 기간에는 고정 | 24 |
안전·확장
| # | 함정 | 대응 | 장 |
|---|---|---|---|
| 38 | 인증된 창을 강제 종료한다 | 세션을 재사용한다 | 25 |
| 49 | 로그인된 창을 강제로 닫아 세션이 날아간다 | 정상 종료로만 닫는다 | 16.5 |
| 50 | 같은 프로필을 두 프로세스가 동시에 연다 | 발행 층에도 잠금을 건다 | 16.5 |
| 51 | CLI 진행 메시지가 결과에 섞여 파싱이 깨진다 | 표준 출력·오류 출력 분리 | 12.5 |
| 52 | 무인 실행에서 인증이 풀려 조용히 실패한다 | 응답에 우리 형식이 없으면 실패 | 12.5 |
| 53 | 모델 호출에 시간 제한이 없어 배치가 멈춘다 | 제한 걸고 넘으면 죽인다 | 12.5 |
| 54 | 라이선스는 통과인데 맥락이 안 맞는 사진 | 검색어 목록을 정해두고 그 안에서만 | 12.6 |
| 55 | 설정 화면의 확인 버튼이 두 개다 | 저장 후 새로고침해 값 확인 | 16.4 |
| 39 | 숫자 게이트는 소재의 선을 모른다 | 차단 목록을 게이트 앞에 | 25 |
| 40 | 축 구분 칸을 안 채워 조용히 섞인다 | 화이트리스트 검증 | 26 |
| 41 | 예약을 발행으로 센다 | 완료·대기·확인필요 셋으로 | 26 |
| 42 | 발행 건수에 접촉·재고를 더한다 | 공개된 것만 센다 | 26 |
| 43 | 가격대를 안 보고 커미션만 본다 | 결제까지의 거리를 본다 | 26 |
| 44 | 요율만 보고 제휴처를 고른다 | 출금 벽과 귀속 방식을 먼저 | 26 |
부록 B
최종 체크리스트
돌리기 전에 훑으세요. 하나라도 비어 있으면 그 자리에서 반드시 터집니다.
구조
- 모든 단계가 독립 실행되고, 실패한 단계만 다시 돌릴 수 있다
- 시각과 난수는 파이프라인 맨 앞에서 한 번만 정한다
- 중간 산출물이 배치별로 남아 어제를 재현할 수 있다
- 설정은 한 곳에 있고, 없으면 시작할 때 죽는다
- 모든 외부 호출이 공통 층을 거치고, 간격이 흔들린다
판정
- 생성 전에 승산 게이트가 돈다
- 경쟁도를 광고 지표가 아니라 문서수로 잰다
- 검색량·문서수·비율·기기 비중 넷을 같이 본다
- 의도 확인 층이 있고, 상위 결과를 실제로 읽는다
- 차단 목록이 게이트보다 먼저 걸린다
- 전 후보 탈락이면 그 축을 비운다
- 통과 키워드가 제목 앞부분에 실제로 들어간다
규격
- 규격이 파일 하나에만 있고, 프롬프트·조립·검수가 모두 그걸 읽는다
- 규격을 프롬프트 문장으로 바꾸는 함수가 있다(손으로 옮겨 적지 않는다)
- 제목 규칙이 노출 경로별로 갈려 있다
- 검수가 함수로 존재하고, 자체 시험이 있다
- 검수 위반 종류가 집계된다
출고
- 발행하지 않고 조립 결과를 확인하는 경로가 있다
- 성공 판정이 비로그인 조회로 이뤄진다
- 200 응답 안의 실패 안내 문구까지 확인한다
- 하루 상한이 코드 관문이고, 축별로 쪼개져 있다
- 상한을 실물로 세고, 공개 예정일 기준으로 센다
- 실행·발행 시각에 지터가 있다
생존
- 진입점이 하나고, 정상인 종료코드가 선언돼 있다
- 락에 PID가 들어 있고, 2차로 나이 상한이 있다
- 상태 파일을 원자적으로 쓴다
- 가드가 주기적으로 돌고, 감지가 아니라 복구까지 한다
- 모든 판정 항목에 증거 파일이 하나씩 정해져 있다
- 증거는 존재만이 아니라 크기·날짜까지 본다
- 알림은 복구 실패에만 오고, 중복이 억제된다
개선
- 통계에 판정 근거와 규격 값이 같이 남는다
- 덜 자란 값은 학습에 안 들어간다
- 순위를 누적이 아니라 나이로 나눈 값으로 매긴다
- 학습이 바꾼 값에 이전 값과 판정일이 함께 기록된다
- 판정일에 효과가 없으면 자동으로 되돌아간다
- 한 번에 하나만 바꾼다
- 실험 배정이 결정적이다(난수가 아니다)
- 내 계정이 만든 반응은 성과에서 빠진다
부록 C
API 레퍼런스
서명이 필요한 조회 API
| 항목 | 값 |
|---|---|
| 서명 알고리즘 | HMAC-SHA256 → Base64 |
| 서명 문자열 | {타임스탬프}.{메서드}.{경로} |
| 주의 | 쿼리스트링을 서명에 넣지 않는다 |
| 타임스탬프 | 밀리초 단위 정수 문자열 |
| 필수 헤더 | X-Timestamp, X-API-KEY, X-Customer, X-Signature |
응답에서 조심할 것
- 검색량이 아주 적으면 숫자 대신
< 10형태의 문자열이 온다 - 공백이 든 키워드는 오류를 낸다. 붙여서 보낸다
- 경쟁도 필드는 광고 기준이다. SEO 판정에 쓰지 않는다
- 연관 키워드가 1,000개 넘게 오기도 한다. 정확히 그 키워드의 행만 골라 쓴다
문서 검색 API
| 목적 | 파라미터 | 쓰는 필드 |
|---|---|---|
| 경쟁도(문서수) | display=1 | total |
| 의도 확인 | display=10&sort=sim | items[].title |
건수만 필요한데 10건을 받아오면 그만큼 느리고 실패 확률이 올라갑니다. 필요한 최소만 요청하는 습관이 무인 환경에서는 안정성으로 돌아옵니다.
호출 예산
| 단계 | 후보당 호출 | 절약 방법 |
|---|---|---|
| 검색량 | 앵커 수만큼 | 24시간 캐시 |
| 문서수 | 검색량 통과분만 | 순서를 검색량 → 문서수로 |
| 의도 확인 | 최종 통과분만 | 제일 마지막에 둔다 |
순서가 곧 절약입니다. 싼 판정을 앞에, 비싼 판정을 뒤에 두세요.
부록 D
30일 실행 계획
한 번에 다 만들려 하면 3주째에 지칩니다. 이 순서로 하면 매주 돌아가는 게 하나씩 늘어납니다.
| 기간 | 만드는 것 | 끝났다는 증거 |
|---|---|---|
| 0일 | STEP 0. 터미널·파이썬·작업 폴더 / 준비 2. 에이전트 설치·키 발급 | python --version 과 claude --version 이 둘 다 찍힌다 |
| 1~3일 | 3장 공통층. 폴더·설정·로그·HTTP | require()가 키 없을 때 죽는다 |
| 4~7일 | 4장 수집. 후보 40건 이상 | candidates.json에 오늘 날짜 40건 |
| 8~12일 | 5·6장 게이트. API 둘 + 캐시 | 후보 40건이 10건 안팎으로 줄어든다 |
| 13~14일 | 7장 의도 확인 | 지표는 통과인데 걸러지는 게 나온다 |
| 15~17일 | 9·10장 벤치마크 측정 + 규격 파일 | style_spec.json이 실측값으로 찬다 |
| 18~19일 | 12·12.5장 생성 + 모델 호출 층 | 짧은 프롬프트로 모델이 실제로 답한다 |
| 20일 | 12.6·13장 이미지·카드 + 검수 | 카드 네 종류가 만들어지고 검수가 통과 |
| 21~22일 | 14·15장 조립 + 발행 없이 확인 | preview 수치가 목표 범위에 든다 |
| 23~24일 | 16.4~16.6장 블로그 준비 + 브라우저 + 주입·발행 | 비공개로 한 건이 실제로 올라간다 |
| 25일 | 16.7장 한 바퀴 리허설 + 첫 글 공개 | 로그인하지 않은 상태에서 그 글이 보인다 |
| 26일 | 16·17장 상한 + 스케줄러 | 다음 날 아침에 사람 없이 돌아 있다 |
| 27~28일 | 18·19·20장 락 + 가드 + 알림 | 일부러 죽여도 30분 안에 살아난다 |
| 29일 | 21·22장 측정 + 진단 | diagnosis.json이 병목을 지목한다 |
| 30일 | 23·24장 학습 + 실험 | 저널에 첫 변경과 판정일이 남는다 |
특히 게이트(8~14일)를 규격(15일 이후)보다 먼저 하는 것. 우리는 반대로 했다가 반나절짜리 개조를 병목이 아닌 곳에 썼습니다. 규격은 노출된 다음에 효과가 나는 층이고, 게이트는 노출 자체를 만드는 층입니다.
부록 E
판정 기준 요약표
복사해서 tuning.json의 출발점으로 쓰세요. 자기 주제에서 2주 정도 돌리면서 조정합니다.
| 기준 | 트래픽 축 | 수익 축 | 조정 신호 |
|---|---|---|---|
| 월간 검색량 하한 | 500 | 300 | 1위인데 유입이 없으면 올린다 |
| 문서수 상한 | 20,000 | 60,000 | 통과분이 너무 적으면 올린다 |
| 비율 하한 | 0.10 | 0.30 | 통과분 성적이 나쁘면 올린다 |
| 기기 비중 하한 | 0.6 | 0.6 | 업무용 검색어가 새면 올린다 |
| 의도 어휘 최소 적중 | — | 6/10 | 엉뚱한 상위 결과가 나오면 올린다 |
| 성숙 기준 나이 | 3일 | 7일 | 수익 축은 전환까지 시간이 걸린다 |
| 실험 최소 표본 | 8/arm | 8/arm | 결론이 계속 뒤집히면 올린다 |
| 승부 인정 격차 | 15% | 15% | 규격이 잡음 따라 흔들리면 올린다 |
| 학습 관찰 기간 | 5일 | 7일 | — |
| 하루 상한 | 2 | 1 | 계정 나이와 반응을 보며 조정 |
이 값들은 우리 주제, 우리 계정, 우리 시점의 실측에서 나온 것입니다. 주제가 다르면 문서수 분포 자체가 다릅니다. 이 표는 출발점이고, 23장의 학습 층이 여기서부터 여러분의 값으로 옮겨갑니다.
중요한 건 숫자가 아니라 왜 그 지표를 보는가입니다. 그건 주제가 달라도 같습니다.
부록 F
지시문 찾아보기
지시문은 전부 각 장 본문에 있습니다. 여기는 어느 장에 무엇이 있는지 찾는 목록입니다.
| 장 | 지시문 | 만들어지는 것 |
|---|---|---|
| STEP 0 | 설치가 안 될 때 | — |
| 준비 2 | 도구 고르기와 설치 / 키 발급 화면이 다를 때 | — |
| 준비 3 | 골모드 선언 | 대화의 기본 규칙 |
| 전략 2 | 제휴 프로그램 조사 | — |
| 3장 | 공통 모듈 만들기 (시작 키트) | envkey · log · net · runctx |
| 4장 | 수집처 찾기 / 후보를 모은다 | collect |
| 6장 | 승산 게이트 / 앵커 추출 | keyword_tool · docs_count · cache · kw_gate · anchor |
| 7장 | 의도 확인 층 / 판정 전체 | intent · pick |
| 10장 | 규격 단일 소스 | style_spec · spec |
| 11장 | 제목 규칙 | title_rules |
| 12장 | 생성 | prompt · parse · extract |
| 12.5장 | 모델 호출 층 | llm |
| 12.6장 | 정보 카드 / 이미지 모으기 | card · images |
| 13장 | 기계 검수 | qa_gate |
| 14장 | 조립 | assemble |
| 15장 | 성공 판정 | verify · preview |
| 16장 | 상한 관문 | quota · schedule_slot |
| 16.4장 | 주제 정하기 | — |
| 16.5장 | 브라우저 세션 만들기 | browser |
| 16.6장 | 에디터 주입과 발행 / 단계별로 확인하기 | publish |
| 16.7장 | 한 바퀴 리허설 | — |
| 17장 | 진입점 / 예약 등록과 옵션 | run_daily · 예약 |
| 18장 | 잠금 | lock |
| 19장 | 자가복구 | guard |
| 20장 | 알림 | notify |
| 21장 | 측정 | store · maturity |
| 22장 | 진단 | diagnose |
| 23장 | 학습과 되돌리기 | evolve |
| 24장 | 실험 | experiment · ab_judge |
| 부록 G | 막혔을 때 쓰는 말 12개 | — |
| 부록 H | 전략 카드 적용하기 | — |
AI가 앞에서 만든 파일을 기억하고 있어야 다음 것이 맞물립니다. 대화가 길어져 느려지면 "지금까지 만든 파일 목록과 각 역할을 정리해 줘"라고 한 뒤, 그 정리를 새 대화 맨 앞에 붙여넣고 이어가세요.
지금까지 만든 파일들을 전부 점검해 줘.

1) 서로 부르는 함수 이름과 파일 이름이 다 맞는지
2) 표준 라이브러리와 이름이 겹치는 파일이 있는지
   (http, json, csv, time, types, select, token, parser, email, queue, random)
3) 발행 층 말고 다른 곳에서 설치가 필요한 라이브러리를 쓴 곳이 있는지
4) 파일을 쓰는 곳이 전부 임시 파일 방식으로 안전하게 저장하는지
5) 실패했을 때 멈춰야 하는 곳과 넘어가야 하는 곳이 구분돼 있는지

문제가 있으면 그 파일 전체를 고쳐서 다시 보여줘. 나는 코드를 못 읽으니까
일부만 고치지 말고 통째로 줘.

그리고 하루 한 바퀴를 처음부터 끝까지 돌려보는 명령을 순서대로 알려줘.
각 단계에서 성공하면 화면에 무엇이 나와야 하는지도 같이.
부록 G
막혔을 때 그대로 복사하는 말
상황별로 이 문장을 그대로 붙여넣으세요. 어떻게 말해야 할지 고민하는 시간이 제일 아깝습니다.
에러가 났을 때
이 에러가 났어.

(여기에 에러 메시지를 처음부터 끝까지 전부 붙여넣기)

나는 코드를 못 읽어. 다음 순서로 답해줘.
1) 무슨 일이 일어난 건지 한 줄로
2) 내가 뭘 잘못한 건지, 아니면 코드 문제인지
3) 고친 파일 전체를 통째로. 일부만 주지 마
4) 다시 실행하는 명령과, 성공하면 화면에 뭐가 나오는지
같은 에러가 세 번째야. 지금까지 고친 방식이 원인을 못 잡은 것 같아.

한 발 물러서서 다시 봐줘.
- 이 에러가 나는 원인으로 가능한 것을 세 가지만 꼽아줘
- 각각을 확인하는 방법을 알려줘 (내가 실행할 명령으로)
- 확인 결과를 알려주면 그때 고치자

바로 고치지 말고 원인부터 좁히자.
이해가 안 될 때
방금 설명을 프로그래밍 모르는 사람 기준으로 다시 해줘.
전문 용어를 쓰면 바로 옆에 한 줄로 풀어 써주고, 비유를 써도 좋아.
그리고 내가 지금 당장 뭘 하면 되는지 한 줄로 알려줘.
그 파일을 어디에 어떻게 저장하는지 모르겠어.
폴더를 만드는 것부터, 파일 이름을 정확히 뭐라고 저장하는지까지
화면에 보이는 대로 순서대로 알려줘.

나는 (윈도우 / 맥) 을 쓰고, 메모장 말고 다른 걸 써야 하면 그것도 알려줘.
확장자가 잘못 붙는 문제가 자주 난다던데 그것도 미리 알려줘.
진행이 꼬였을 때
지금까지 만든 파일 목록과 각 파일이 하는 일을 정리해 줘.
- 파일 이름 / 한 줄 설명 / 어느 폴더에 있는지
- 아직 안 만든 것도 목록으로
- 지금 어디까지 왔고 다음에 뭘 하면 되는지 세 줄로

이걸 새 대화에 붙여넣고 이어갈 거야. 그 목적에 맞게 정리해 줘.
지금까지 만든 걸 정리하고 깨끗하게 다시 시작하려고 해.
- 지우면 안 되는 파일이 뭔지 알려줘 (특히 키가 들어간 것)
- 나머지를 안전하게 지우는 방법
- 다시 만들 때 순서

지우기 전에 백업해야 할 게 있으면 그것부터 알려줘.
돌아가는지 확인할 때
오늘 파이프라인이 제대로 돌았는지 확인하고 싶어.
아래를 한 번에 확인해 주는 점검 파일을 만들어 줘.

- 수집 결과 파일이 오늘 날짜이고 비어 있지 않은지
- 판정을 통과한 게 몇 건인지
- 오늘 실제로 나간 게 몇 건인지
- 실패한 단계가 있으면 어느 단계이고 왜인지

결과를 사람이 읽기 좋은 형태로 보여줘.
문제가 있으면 무엇을 하면 되는지도 한 줄씩 알려줘.
며칠 동안 새 결과물이 안 나온 것 같아. 원인을 찾아줘.

가능성을 순서대로 확인하는 방법을 알려줘.
1) 예약 작업이 아예 실행되지 않았나 (실행 기록 확인법)
2) 실행은 됐는데 수집이 0건이었나
3) 수집은 됐는데 판정에서 전부 떨어졌나
4) 판정은 통과했는데 만들다가 실패했나
5) 만들었는데 내보내기에서 막혔나

각 단계를 확인하는 명령과, 정상일 때 뭐가 보여야 하는지 알려줘.
개선하고 싶을 때
발행은 되는데 유입이 거의 없어. 어디가 문제인지 순서대로 진단해 줘.

확인 순서는 이렇게 해줘. 위에서부터 보고, 처음 0인 곳이 병목이야.
1) 색인 — 제목 그대로 검색하면 나오나
2) 순위 — 사람들이 실제로 칠 검색어로 앞쪽에 있나
3) 노출 — 유입 경로별로 얼마나 노출되나
4) 클릭 — 노출 대비 들어온 비율
5) 체류 — 들어와서 얼마나 머무나

각 단계를 확인하는 방법을 알려주고,
병목이 어디인지 판정한 다음 거기만 고치는 방법을 알려줘.
병목이 아닌 곳은 고치지 말자고 나한테 말려줘.
판정 기준을 조정하려고 해. 지금 상황은 이래.

(아래 중 해당하는 것만 남기고 나머지는 지우세요)
- 통과하는 소재가 너무 적어서 발행할 게 없다
- 통과는 많이 되는데 성적이 나쁘다
- 1위를 하는데도 사람이 안 온다
- 엉뚱한 검색어가 통과한다

어느 값을 어느 방향으로 얼마나 바꾸면 되는지 알려줘.
그리고 바꾸기 전 값과 며칠 뒤에 판정할지를 기록으로 남기게 해줘.
효과가 없으면 자동으로 되돌아가게.
한 번에 하나만 바꾸자.
새로운 축을 하나 추가하려고 해. 주제는 (여기에 적으세요) 야.

추가할 때 같이 손봐야 하는 곳을 전부 찾아서 한 번에 고쳐줘.
1) 판정 기준 파일에 이 축의 기준
2) 규격 파일에 이 축만 다른 항목
3) 제목 규칙의 축 분기
4) 하루 상한에 이 축의 몫 (총량은 그대로 두고 나눠줘)
5) 감시 목록에 이 축의 증거 파일
6) 통계 저장의 축 이름 목록

하나라도 빠지면 이 축이 다른 축에 조용히 섞이거나,
죽어도 아무도 모르는 상태가 돼. 빠진 게 없는지 마지막에 확인해 줘.
부록 H
전략 카드 — 골라 쓰는 아이디어 30
전부 할 필요는 없습니다. 지금 상황에 맞는 것 두세 개만 골라 쓰세요. 각 카드에 어느 상황용인지 적어뒀습니다.
소재를 고르는 전략
| # | 전략 | 언제 쓰나 |
|---|---|---|
| 1 | 고유명 사냥. 카테고리 검색어는 버리고 제품·장소·인물의 고유한 이름만 노린다. 헤드는 10년치 재고와 싸우지만 고유명은 대상이 바뀔 때마다 문서가 갱신된다 | 계정이 어릴 때 |
| 2 | 규격 조합. 제품군에 용량·인치·리터를 붙인다. 구매 직전에 치는 말인데 쓴 사람이 적다 | 상품 축 |
| 3 | 저인지 브랜드. 검색은 있는데 아무도 안 쓴 브랜드를 찾는다. 문서 100건대가 실제로 존재한다 | 상품 축 |
| 4 | 시드 확장. 큰 단어 하나를 넣어 연관 키워드를 1,000개 뽑고, 그 안에서 고유명만 걸러낸다. 사람이 소재를 고르지 않게 된다 | 소재가 마를 때 |
| 5 | 접미어 금지. 추천·가격·순위·비교가 붙는 순간 문서가 수십만 건이 된다. 후보 생성 단계에서 아예 뺀다 | 항상 |
| 6 | 사건 롱테일. 화제성 1위가 아니라 그 사건의 곁가지를 노린다. 1위는 모두가 쓰고 곁가지는 아무도 안 쓴다 | 이슈 축 |
| 7 | 의도 대조. 상위 10건을 실제로 열어 우리 주제가 몇 건인지 센다. 지표가 통과시킨 오답을 여기서 잡는다 | 수익 축 |
| 8 | 기기 비중 필터. 모바일이 PC보다 적은 검색어는 업무용이다. 내 독자가 아니다 | 항상 |
이기는 자리를 만드는 전략
| # | 전략 | 언제 쓰나 |
|---|---|---|
| 9 | 빈틈 포지션. 상위 글이 잘하는 걸 더 잘하려 하지 말고, 그 형식이 구조적으로 못 담는 것을 찾는다. 후기는 자기가 겪은 하나만 쓴다 | 강자가 있을 때 |
| 10 | 확인표 포맷. 등급별 차이·조건별 가격·운영 시간·취소 규정처럼 후기에 안 나오는 항목을 한 화면에 모은다. 겪지 않고도 정확히 쓸 수 있다 | 체험형 주제 |
| 11 | 노출 경로별 제목. 추천 피드에서 먹는 축과 검색에서 먹는 축은 제목 규칙이 정반대다. 같은 규칙을 쓰면 한쪽이 손해 | 축이 둘 이상 |
| 12 | 피드 진입. 검색 지수 없이 노출되는 경로가 있다. 신생 계정에는 이쪽이 더 크다. 주제 분류를 비워두면 아예 못 들어간다 | 계정이 어릴 때 |
| 13 | 시리즈 묶기. 이어지는 소재를 만들고 서로 링크한다. 한 편이 뜨면 나머지가 같이 올라온다 | 소재가 연속될 때 |
| 14 | 재활용 축. 하나의 소재를 형태만 바꿔 다른 채널로 보낸다. 만드는 비용은 거의 안 늘고 노출 면적이 는다 | 축이 안정된 뒤 |
| 15 | 갱신 우위. 옛 글이 상위인 검색어를 찾는다. 정보가 낡았으면 새 글이 이긴다 | 정보성 주제 |
돈으로 바꾸는 전략
| # | 전략 | 언제 쓰나 |
|---|---|---|
| 16 | 합산 출금. 브랜드마다 따로 가입하면 출금 벽에 흩어져 한 푼도 못 받는다. 여러 곳을 한 계정으로 묶는 중개를 먼저 쓴다 | 시작 단계 |
| 17 | 가격대 조정. 수수료율보다 결제까지의 거리다. 클릭 115에 주문 0이었던 이유가 200만원짜리였다 | 클릭은 나는데 주문이 없을 때 |
| 18 | 독자가 이미 찾는 것. 쿠폰·할인 정보를 상위 글이 다루고 있다면, 링크가 놓일 자리와 정확히 같은 자리다. 억지로 끼우는 게 아니다 | 제휴 축 |
| 19 | 안 맞으면 안 붙인다. 글 내용과 상품이 안 맞으면 링크 없이 낸다. 억지로 붙이면 광고글이 되고 축이 죽는다 | 항상 |
| 20 | 광고 먼저 신청. 심사에 운영 기간이 걸리고 수익은 터지는 글 하나에 몰린다. 터진 뒤 신청하면 기다리는 사이 트래픽이 죽는다 | 지금 당장 |
| 21 | 수익 계정 통합. 여러 제휴를 한 계정으로 모으면 정산과 세금을 한 곳에서 본다. 나중에 나누는 건 어렵다 | 두 번째 제휴부터 |
| 22 | 실적 귀속 확인. 링크 발급 계정에 붙는지 게시 채널에 붙는지 먼저 확인한다. 모르고 붙이면 몇 주치가 사라진다 | 제휴 붙이기 전 |
| 23 | 자체 상품은 나중에. 이익률은 최고지만 결제·신고가 필요하다. 앞의 둘로 트래픽을 만든 뒤 얹는다 | 유입이 붙은 뒤 |
오래 가게 하는 전략
| # | 전략 | 언제 쓰나 |
|---|---|---|
| 24 | 상한을 코드로. 재량에 남기면 어느 날 반드시 터진다. 축별로 쪼개서 관문에 박는다 | 지금 당장 |
| 25 | 빈 축 허용. 오늘 이길 소재가 없으면 그냥 비운다. 못 이길 글은 이력만 채운다 | 항상 |
| 26 | 발행 없이 확인. 규격을 바꿀 때마다 실제로 내보내면 계정이 실험장이 된다 | 규격을 만질 때 |
| 27 | 증거 기반 감시. 항목마다 "성공했으면 이 파일이 오늘 것"을 정한다. 정할 수 없는 항목은 자동 판정 대상이 아니다 | 무인 전환 직후 |
| 28 | 되돌릴 수 있게. 기준값을 바꿀 때 이전 값과 판정일을 같이 남긴다. 못 되돌리는 변경은 도박이다 | 학습을 붙일 때 |
| 29 | 직교 배정. 여러 항목을 동시에 실험하면 같은 발행량으로 표본이 몇 배가 된다 | 표본이 안 찰 때 |
| 30 | 접는 기준 미리. 몇 달 안에 어떤 지표가 어디 못 가면 접는다를 시작할 때 정한다. "좀 더 지켜보자"가 영원해진다 | 축을 시작할 때 |
지금 상황에 해당하는 카드 번호를 골라, 아래처럼 AI에게 주면 됩니다.
지금 내 상황은 이래.
(예: 발행은 매일 되는데 유입이 거의 없다 / 클릭은 나는데 주문이 없다 /
     소재가 매일 전부 탈락한다 / 축을 하나 더 늘리고 싶다)

내 주제는 (여기에 적으세요) 이고, 시작한 지 (몇 주) 됐어.

이 상황에서 지금 손대야 할 것 하나만 골라줘.
- 왜 그것부터인지 세 줄로
- 구체적으로 뭘 바꾸는지
- 바꾸고 나서 며칠 뒤에 무엇을 보면 효과를 알 수 있는지
- 효과가 없으면 어떻게 되돌리는지

한 번에 여러 개 바꾸자고 하지 마. 하나만.